别停留在网页代码片段!Cursor/Claude Code 全局项目上下文引擎重构科研编程体系
- 2026-09-26 03:21:42
导语

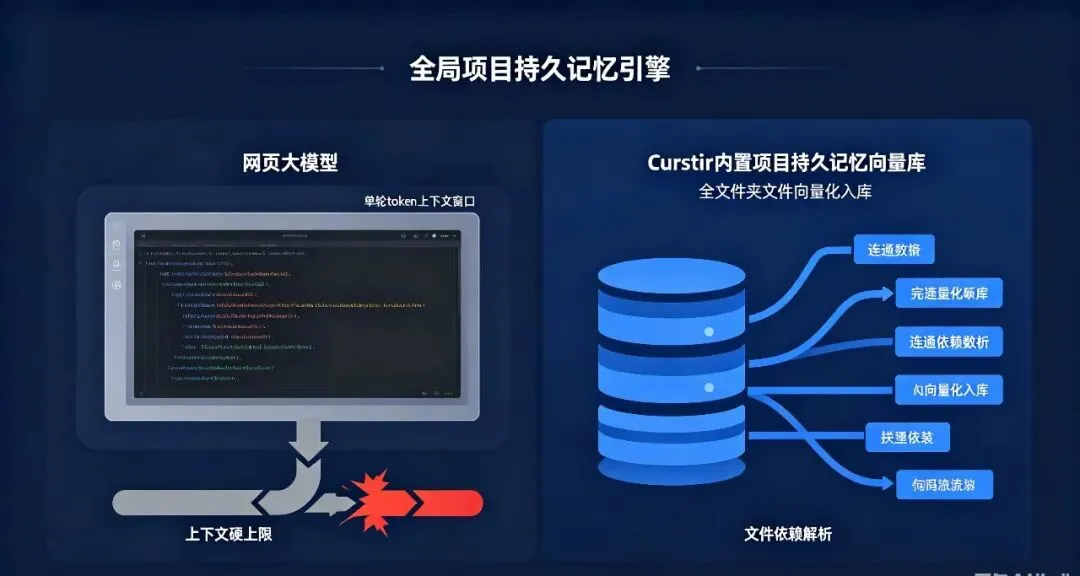
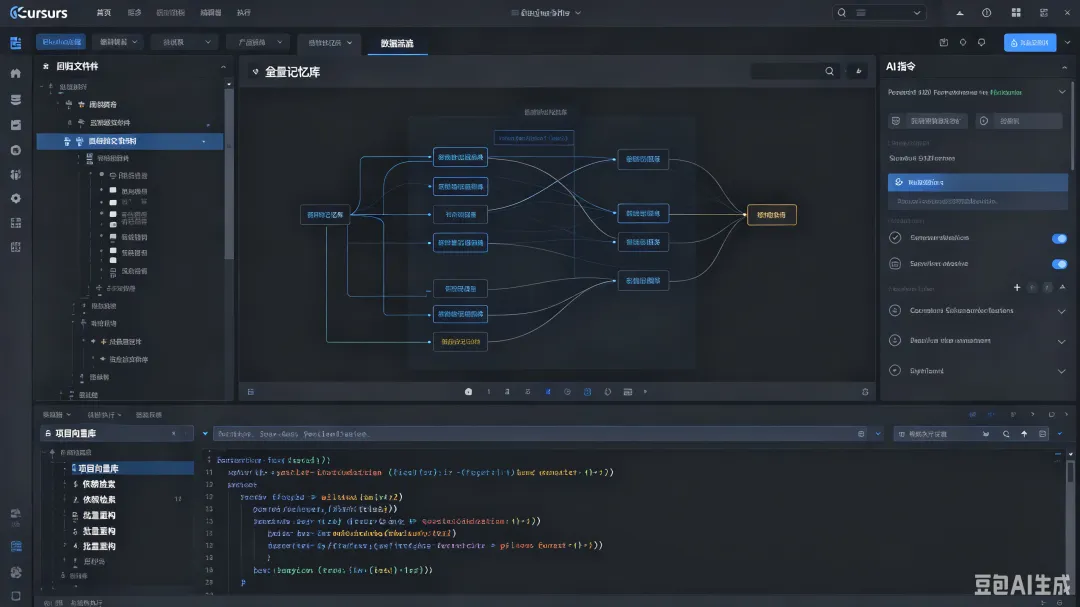
95% 科研编程使用者局限于网页对话复制代码片段,网页通用 LLM 存在固定 token 长度上限,无法读取整套课题数十个脚本、数据配置、绘图模块的全局依赖关系,生成代码变量未定义、导入路径错乱是常态。Cursor 与 Claude Code 内置独立项目持久记忆向量库,突破单轮对话字符限制,跨文件批量重构、同步修正论文实验描述,从架构层面解决网页 AI “盲人写代码” 核心短板。市面上浅教程仅演示单文件简单生成,本文深挖底层原理,配套多工程标准化重构工业代码,适配数值仿真、机器学习各类科研项目。 【图 1 配图生成指令】16:9 深蓝代码科技主图,左右底层架构对比矢量图;左侧网页 LLM 单轮 token 上下文窗口,灰色截断数据流,代码依赖链条断裂标红;右侧 Cursor 内置项目持久记忆向量库,全文件夹文件向量化入库,完整依赖蓝色连通数据流,标注「网页 LLM 上下文硬上限」「Cursor 全局项目持久记忆引擎」。
01
网页对话 LLM 上下文窗口底层硬限制
通用网页大模型上下文窗口存在物理上限,衍生三类不可规避工程缺陷,无法依靠优化提示词解决:
单次输入强制截断:大型仿真项目总代码超万字符,后半段依赖文件直接丢失; 无持久语义缓存:关闭对话向量全部清空,隔天修改需要重新上传整套工程; 无文件树解析引擎:无法识别跨文件 import 函数,运行必报路径 / 变量错误。 很多仿真方向硕博花费数天调试代码,根源就是网页模型无法读取完整工程全局依赖。
02
Cursor 项目持久记忆向量库底层原理
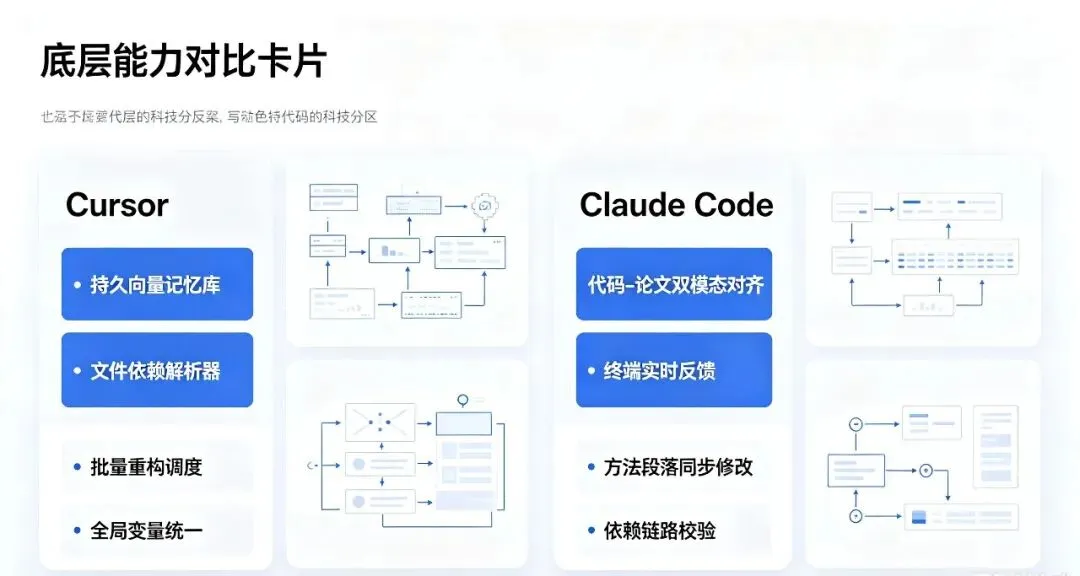
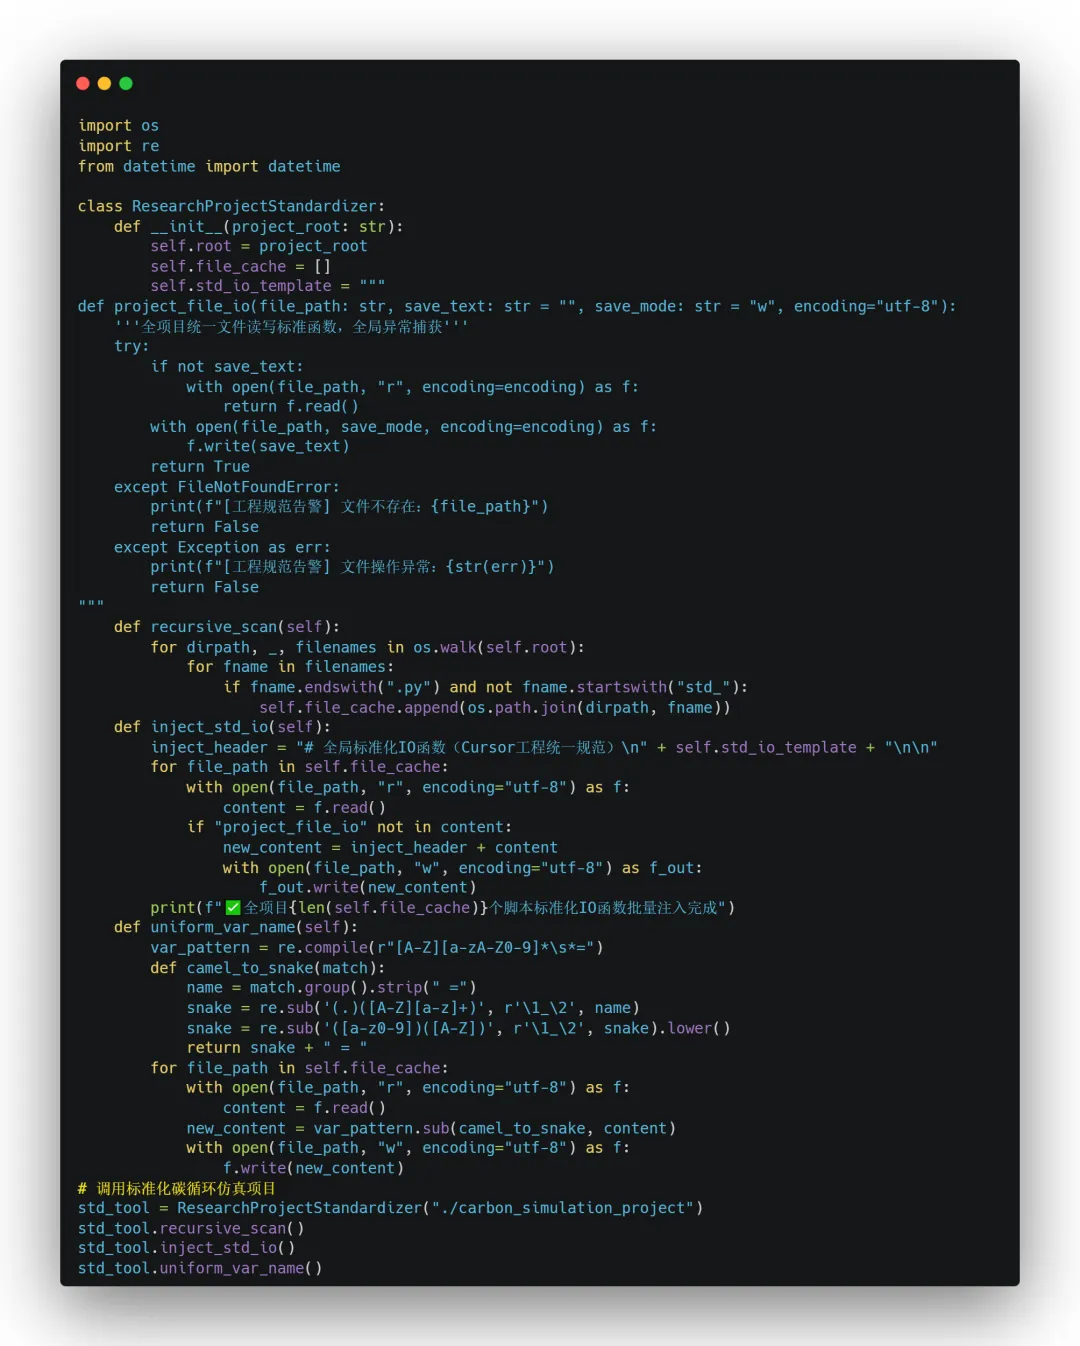
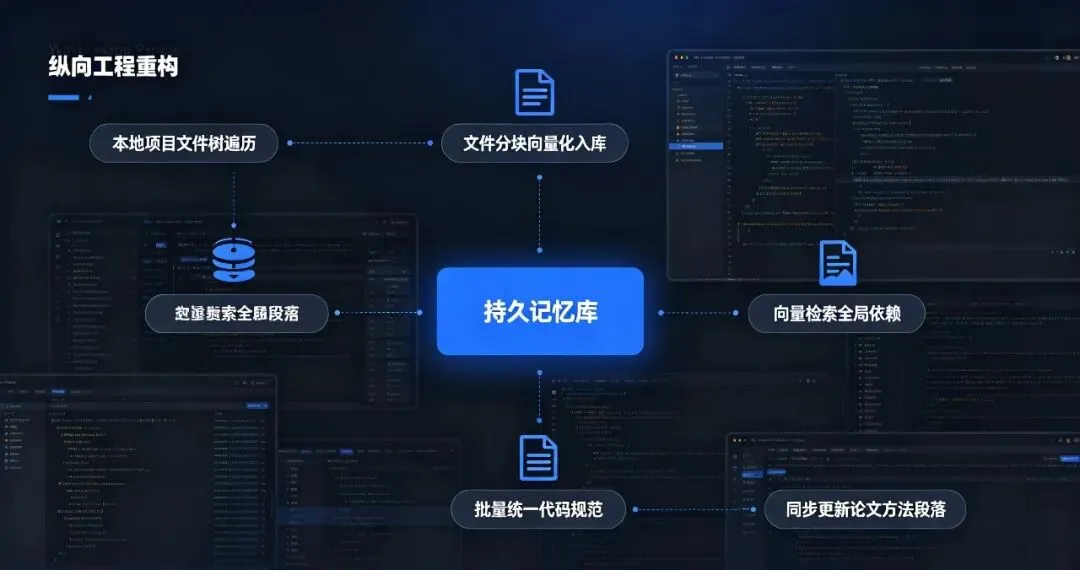
Cursor 在本地项目根目录生成专属向量数据库,三层完整处理链路:自动递归扫描全部工程文件、拆分函数类为独立向量块、用户指令时自动检索关联依赖,向量永久本地存储,重启电脑不丢失工程记忆。修改任意脚本,引擎同步调取全部关联模块,批量统一代码命名、异常捕获规范。
多工程统一标准化重构完整工业代码
03
网页 LLM vs Cursor/Claude Code 核心能力对照表界
表格清晰展示网页 AI 的底层天花板,编辑器智能体依靠本地向量存储,从根源解决多文件科研工程开发低效问题。
04
Claude Code 代码 - 文档双模态对齐底层引擎
Claude Code 搭载文本 - 代码交叉注意力编码器,可同时读取 Python 仿真脚本与 LaTeX/Word 论文原稿,自动匹配变量、实验描述语义。修改绘图、统计代码时,引擎同步定位论文结果章节,生成配套文字修改建议,彻底杜绝图表数据与正文描述不匹配的返修问题,这是纯网页模型无法实现的双向绑定能力。
05
科研代码资产长期沉淀底层规范
每个课题创建独立项目文件夹,方便向量引擎全局读取; 全项目统一 IO、统计、绘图底层函数,复用标准化模板; 代码与论文原稿置于同一目录,启用 Claude Code 双模态绑定; 按月批量重构老旧实验脚本,统一编码风格; 课题专属仿真模块存入向量库,长期复用减少重复开发。
06
结语
绝大多数科研编程使用者只看见编辑器 AI “自动写代码” 表层功能,忽略 Cursor 本地持久向量记忆库、Claude Code 双模态交叉注意力编码器两大底层架构革新。网页通用 LLM 受 token 物理上限束缚,永远无法读懂整套多文件科研工程;编辑器内置 Agent 本地持久存储全局文件语义,批量重构杂乱历史代码,同步绑定论文实验描述,从底层消除代码依赖报错、图文脱节两大高频返修痛点。配套递归标准化重构工业脚本,老旧仿真工程改造周期压缩 90%。
[1] Cursor 本地项目向量持久化存储底层技术文档 [2] Claude Code 文本 - 代码双模态交叉注意力编码器白皮书 [3] 大型科研仿真工程代码标准化行业规范
版权声明
Ai尚研修丨专注科研领域
技术推广,人才招聘推荐,科研活动服务
科研技术云导师,Easy Scientific Research

