一个有趣的思路:从网页源代码里挖掘赚钱机会
- 2026-11-21 07:55:54
你可能会听人说:少看短视频,对脑子不好;
但你肯定从来不会听到有人说:少用百度谷歌,对脑子不好。
差别在于,检索是一种能力,不同的检索能力,决定着不一样的人会看到不一样的信息。
同样的,提问更是一种能力,因此即使如今AI如此的普及和平等,但人与人之间的差距反而会越来越大。
我这三年在会员内容里分享了很多很多信息,包括不限于:
稳定持续的项目、大量的商品资源、另类的产品服务、五花八门的线上广告、千奇百怪的工具应用、
脑洞大开的商业模式、特定内容的自媒体号、不可见的转化数据、巧妙的引流思路 等等;
很多是别人在默默赚钱的事情;
这些都是我在各种免费渠道挖掘到的,不花钱,但能换成钱;
渠道是免费的,关键在于你用什么思路去挖掘。
除了挖掘出来的信息,挖掘的思路我也都分享在会员里,都是可验证和可复用的操作。
这么说吧:
挖掘信息的能力,是你和别人产生信息差的最低成本的方式。
上周在会员内容里分享了一个特定的挖掘思路:《一种基于html代码的挖掘思路》
除了原本讲的角度之外,这两天还想到了另外的角度,我单独写在这里给大家看看。
下面是一段html代码:
<a id="logo" class="xxx-yyy-zzz" href="https://www.baidu.com/">百度</a>
假设这就是一个网页;
在寻常我们理解的传统搜索引擎眼里,比如百度谷歌,它们在收录这个网页并对其索引建库时,只有百度这两个字,会做处理并可被用户检索到。
href是这个a标签的超链接,当然也会处理,毕竟超链接是重要字段。
其他类似:logo、xxx-yyy-zzz,这些都是css的自定义名称,是html代码的一部分,不作为用户可检索的字段;
因为没有用户要去搜索这些,用户搜索的是网页前端可见的文本内容。
一份网页HTML代码,除了我们前端可见的文本内容之外,还有诸如:Meta元信息、js代码、css代码、注释文本 等等,
这些搜索引擎一般都不会作为索引内容。
所以,你在百度谷歌搜索xxx-yyy-zzz,不会有某个网页因为css代码包含这样一段文本,而被匹配搜索到。
但这些内容也有特别的价值。
wpa.qq.com,这是QQ在线唤起临时会话的超链接的域名,比如:
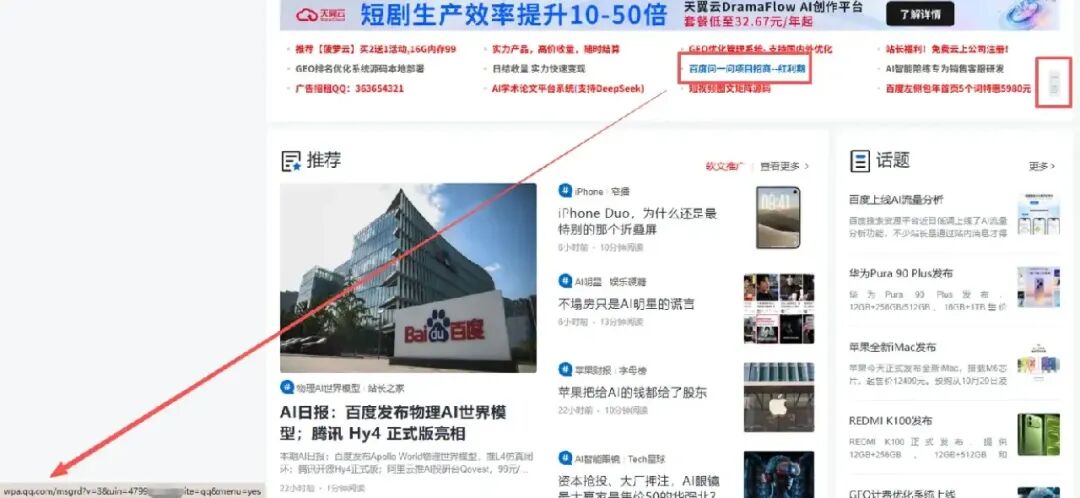
点击这个文字广告,就能马上打开广告主的qq临时聊天窗口,与之沟通。
所以,如果这样一段包含wpa.qq.com的超链接出现在网页前端,我们可以在搜索引擎里搜索到:
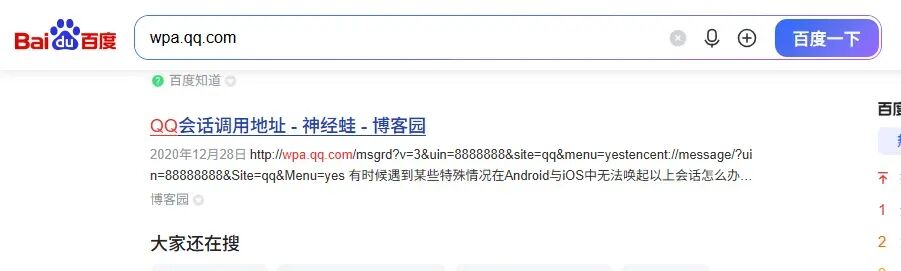
如果他存在的形式是a标签的超链接,那我们可以利用第三方平台的外链数据来查询:
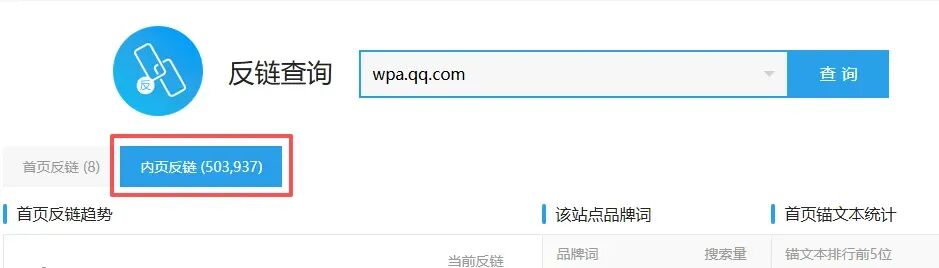
这么做的意义就是:
当有人在网上做一些各种各样的小广告时,我们可以通过这样的方式大量将这些广告找出来,去发现别人在做的项目。
但问题是,通常情况下,这些广告都是花钱在别人网站上做的文字付费广告,网站方用于展示文字广告的区块,一般都是使用js加载的,不会写死,因为广告随时要换;
这些广告在网页前端看得到,但搜索引擎不会提取和索引,所以这些内容无法通过搜索引擎检索。
这种情况下,有一种搜索工具就派上用场了:
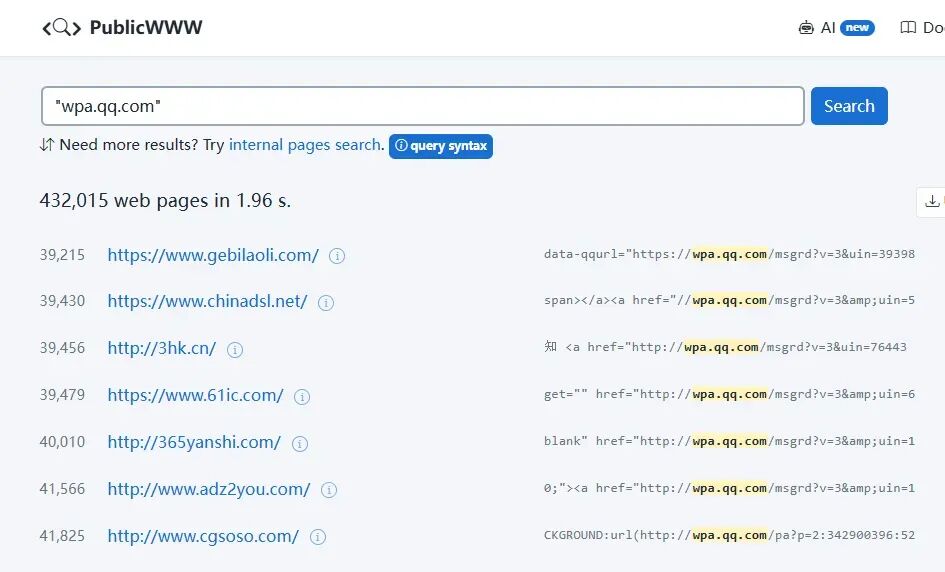
我这样搜索,是希望完整匹配到网页源代码里出现的wpa.qq.com,可以看到有40几万个页面;
而实际上第一行看到的,它并不是一个前端可视的a标签超链接:
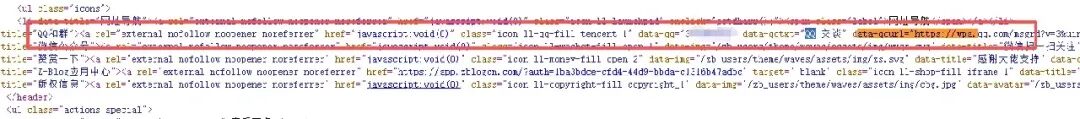
是个动态js,你在传统搜索引擎那里是搜索不到的。
这种搜索工具的特点是:
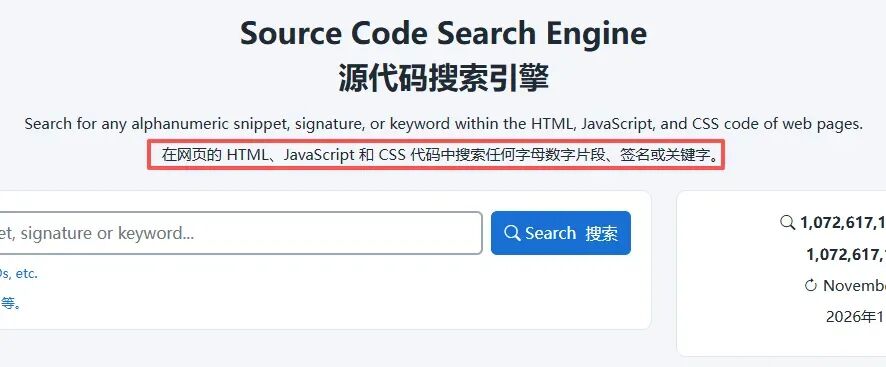
也就是除了正文内容,它还可以检索css、js的代码内容。
buy.stripe.com,它是Stripe的支付链接的其中一个域名,比如https://buy.stripe.com/6oEaHWbNU8GNe8E3cc这个页面:
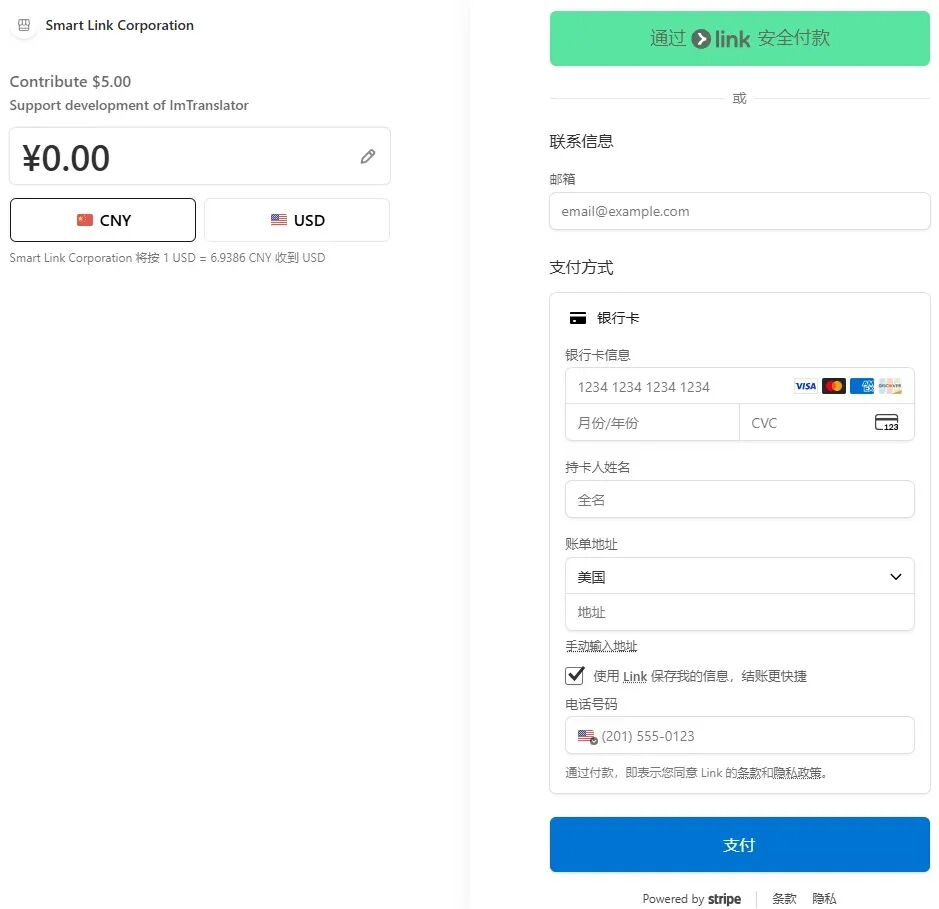
这就是一个支付结算页面。
它作为用户点击支付的链接,可能存在于a标签里,也可能存在于动态加载的js代码里,
但无论如何,我们在谷歌里是无法直接找到大量的各种buy.stripe.com的子链接的。
但这种特别的搜索工具可以:
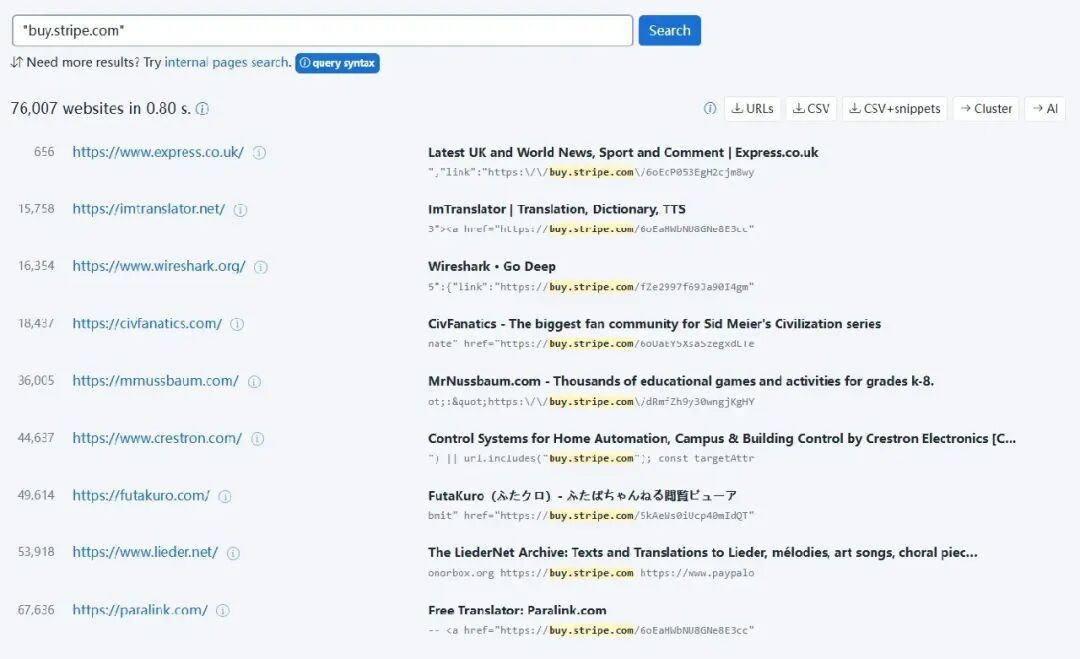
一下子可以找到几万个页面,这一个个buy.stripe.com的子链接,都是一个个支付结算页面;
而你又知道它在哪个网站,那么就能知道这个网站基于什么服务在收费。
这是非常高效又有价值的挖掘方式。
在传统搜索引擎里,我们一般不会去做这样的搜索:
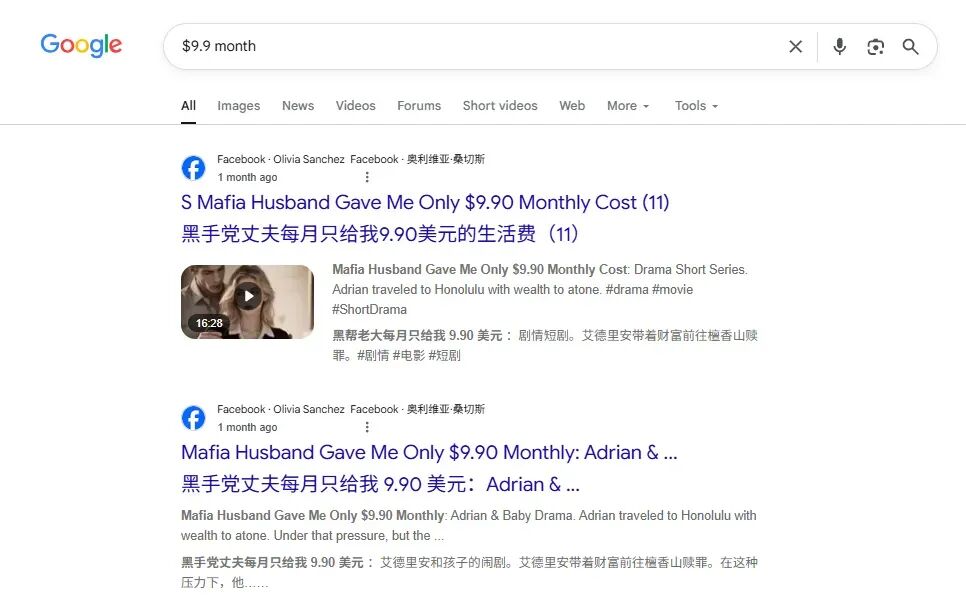
有很多网站的/pricing页面的正文里,清楚的写着它们的产品服务怎么收费,收多少钱:
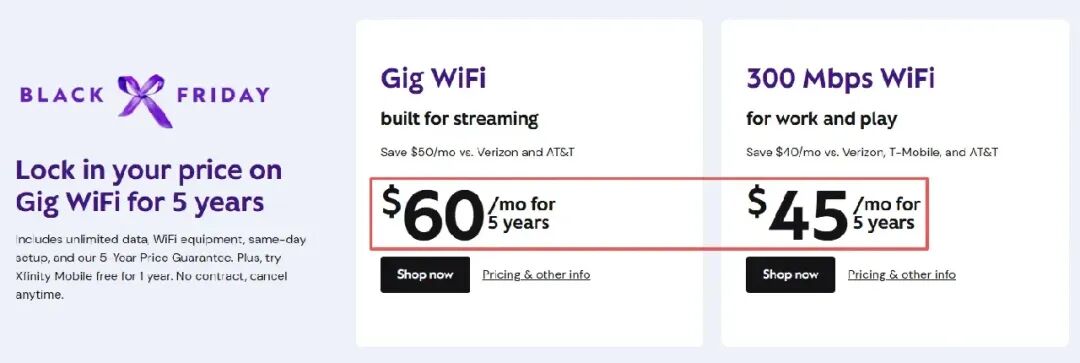
但是你无法直接通过传统搜索引擎去检索这样的内容,因为搜索引擎默认优先展示的是标题包含,而不是正文包含。
而publicwww这个网站支持正则搜索:
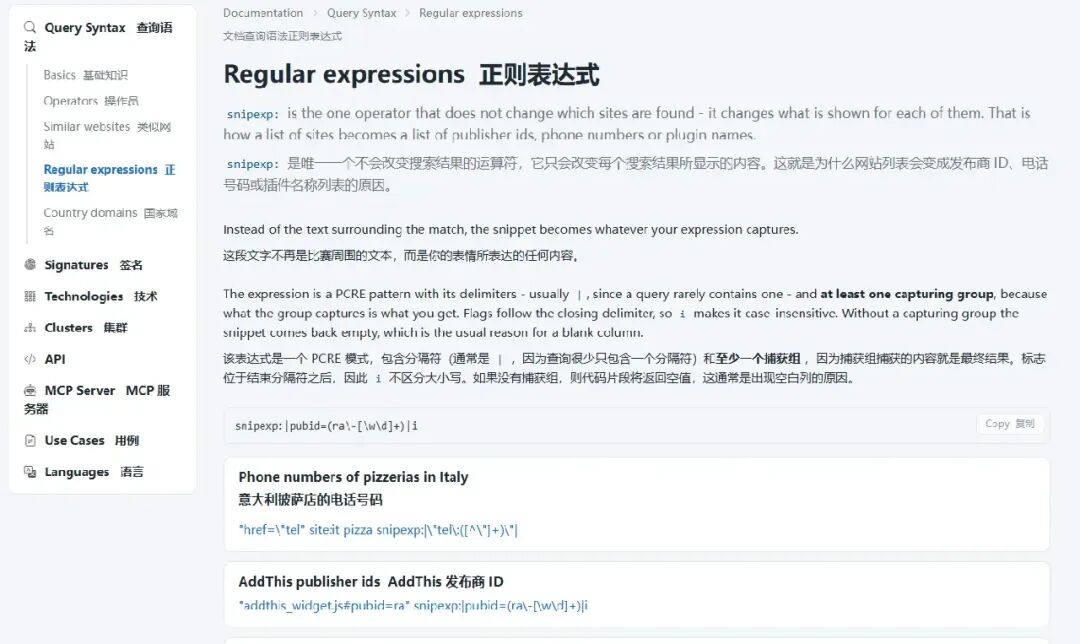
我不需要去了解它的规则,我直接给gpt,让它理解这个网站的正则规则,
然后让它给我写一个匹配:有$、后面带任何数字或者多位数字的这样一段文本的规则:
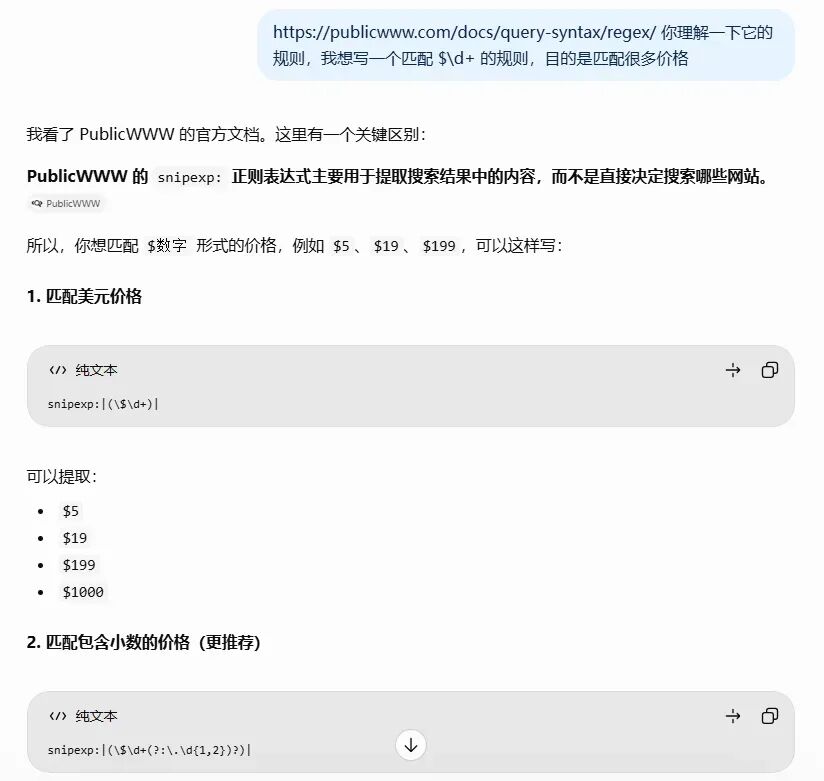
然后我们可以这样去搜索:
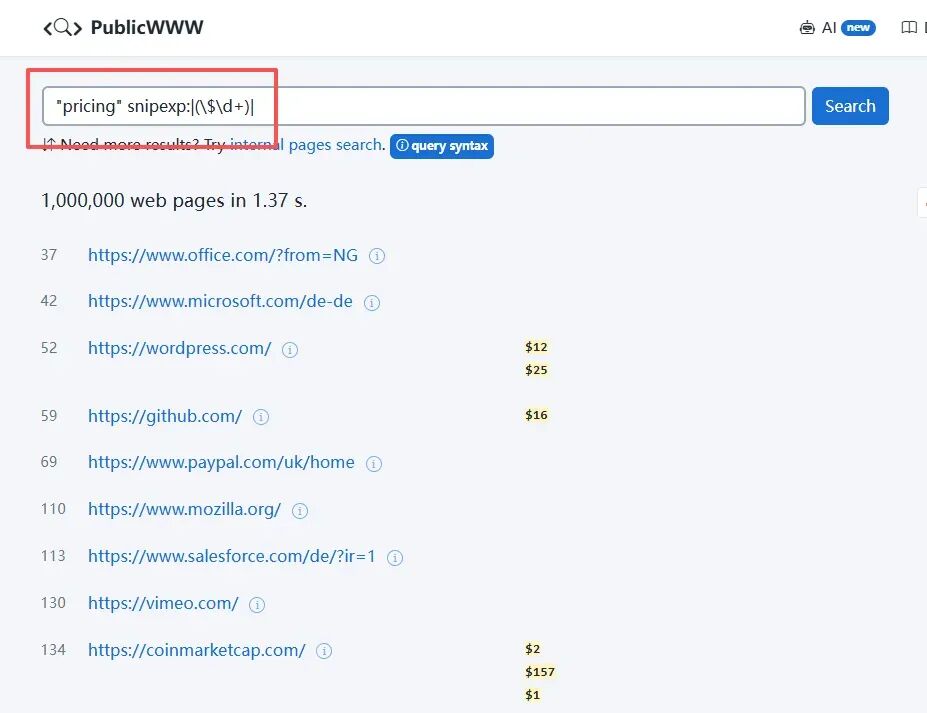
这表示网页里需要包含pricing,且还存在符合后面这一套规则的文本,能匹配各种数字;
于是下面就可以找到很多包含的,很多打开就是我上面展示的那些价格介绍的内容。
这是传统搜索引擎无法做的检索方式;通过这种方式,又可以无差别的去挖掘很多商业服务。
其他还有不同的一些角度,我之前写在了会员内容里,这里不展开了;
这篇文章主要补一下之前没写的角度:
前面我们利用了这种特殊的检索方式,去弥补传统搜索引擎无法做到的检索;
因为传统搜索引擎不保留js、css等这些内容的检索。
这是两种搜索工具的差异,但它们之间还不止这个差异:
百度或者谷歌,这些传统搜索引擎在收录网页的时候,是有标准的,也就是内容质量标准。
质量差的,是不会收录的;
但是,有很多页面,它的内容只是单一,只是重复,它可能不符合搜索引擎的标准,但对于挖掘商业信息的我们来说,是有价值的。
而类似publicwww这样的工具,一方面在技术层面上,它无法做很精细的质量判断,另一方面在产品层面,也不需要;
它的目的是支持用户可检索更多的信息。
所以它的爬虫应该都是无差别抓取的,只要让它发现网页链接。
比如这样一个页面:
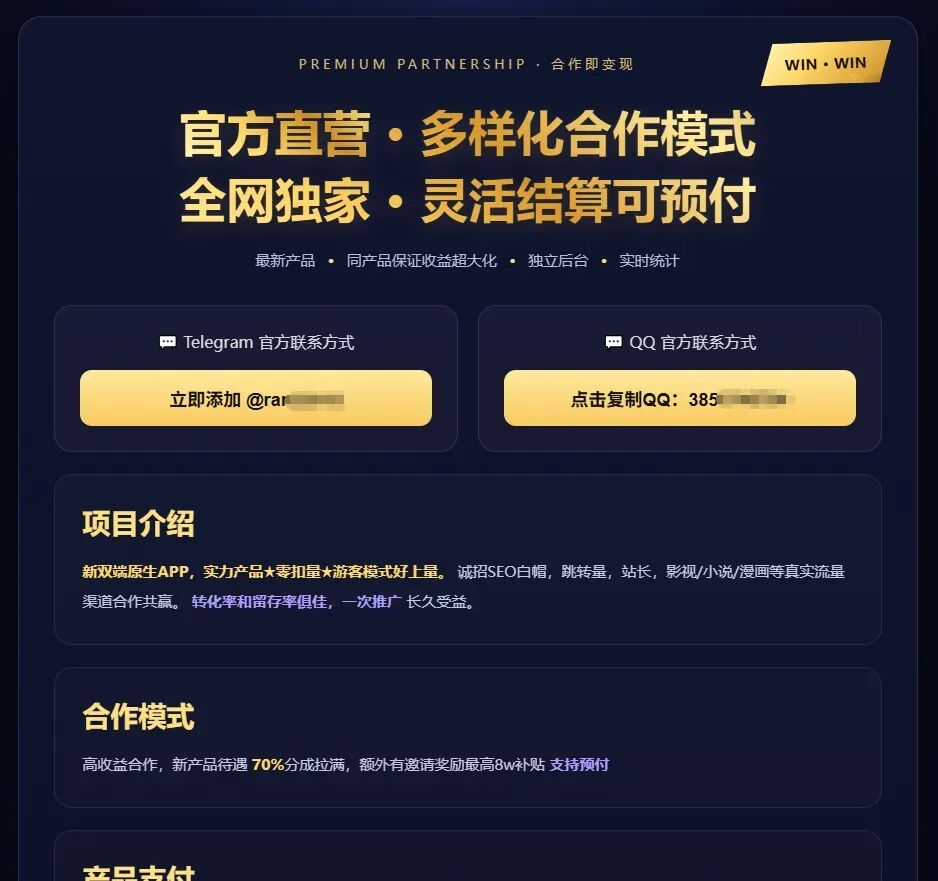
这是一个广告宣传页面,它的信息质量和展示方式,以及链接曝光度,注定它大概率不会被传统搜索引擎收录。
所以我们在百度这样搜索:
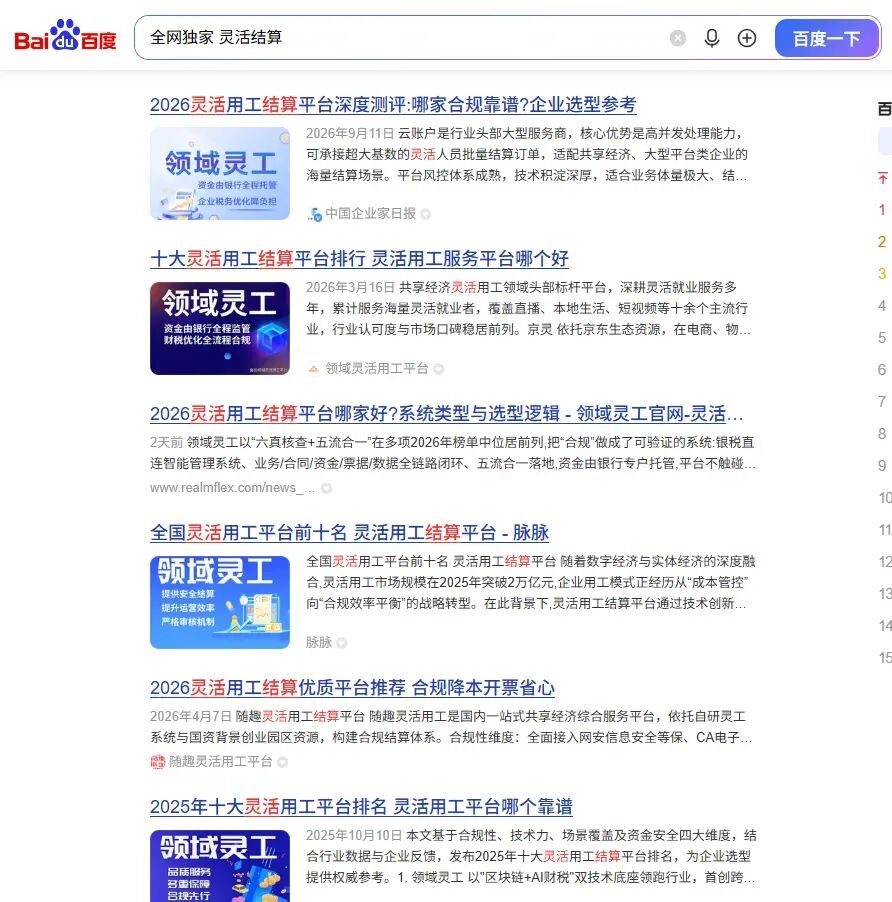
大概率你看到的,都不是你想看到的无关内容,但如果放到publicwww搜索:
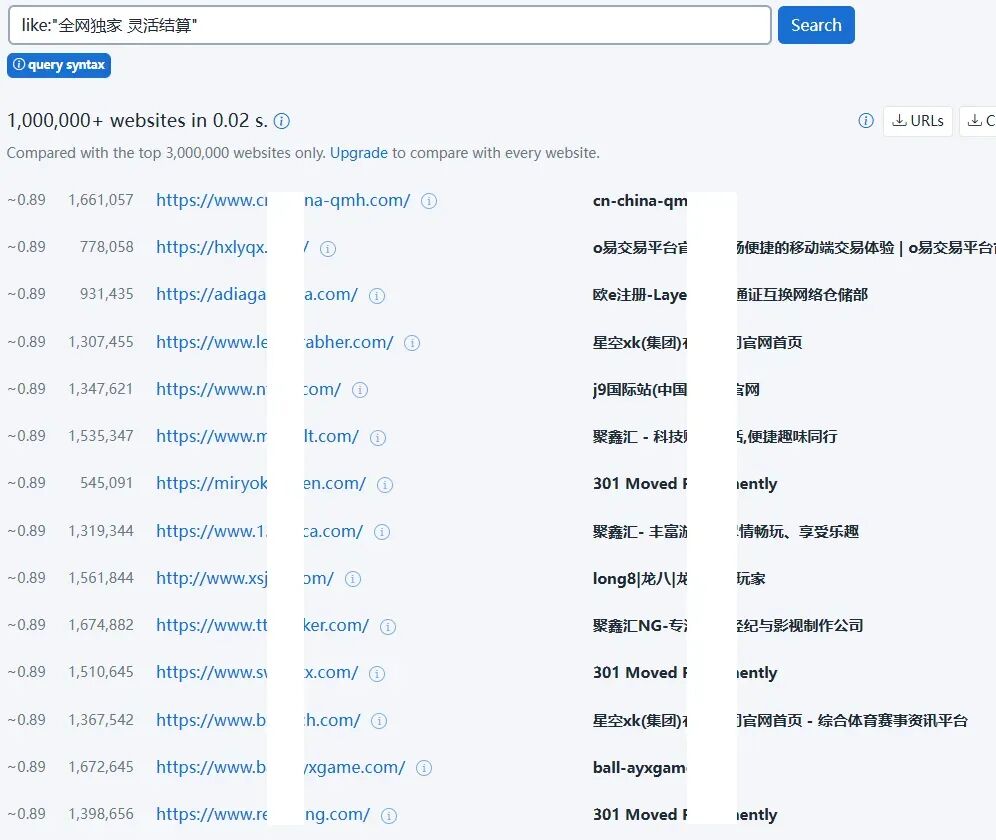
我特意把搜索结果遮住,你看很多标题都说明里面的内容不简单;
这是因为我们使用的关键词比较特殊。
所以我们还可以这样搜索:
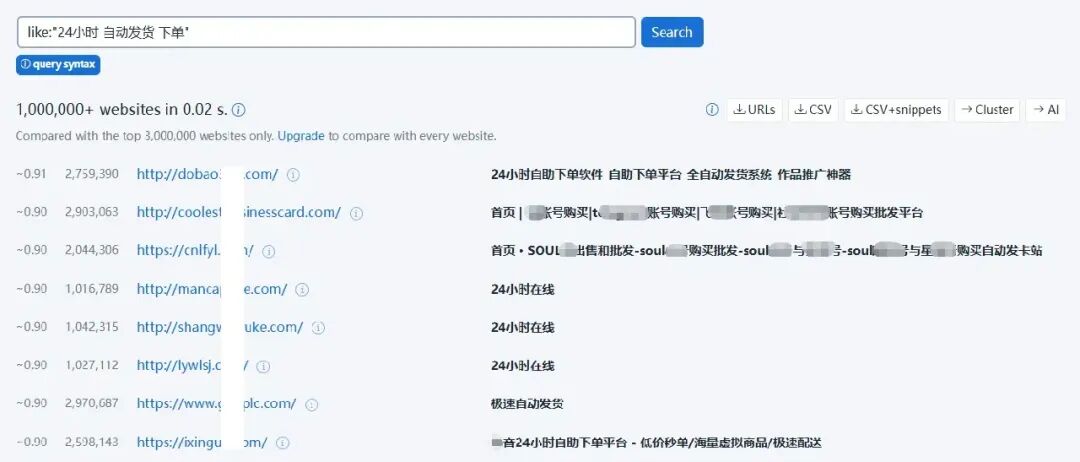
什么意思呢,我在以前讲过收集全网网页贴片广告的思路,你可以收集大量的单页广告,统计里面高频出现的文案,比如:
24小时自动发货、虚拟产品、不退不换、加微信 等等等等;
或者如果你嫌麻烦,现在AI也很方便,让它给你梳理这些:
无差别的、又是打广告必然出现的词汇,然后用这些词汇去无差别的检索各种广告页面。
你就有机会看到很多别人没看到的信息。
基于这类关键词的挖掘,有很多业务都不好展示,这里就不贴出来了。
以上就是这篇文章所讲的,利用publicwww这种特别的搜索工具来进行商业信息挖掘的思路。
类似publicwww这样的工具也还有,比如:searchwebcode.com;
这些站点都支持js、css的检索,只不过都需要付费,你只能在需要的时候集中挖掘。
这篇文章只是提供一些检索角度。
对于这种挖掘思路,如果你有更好的检索角度,欢迎与我交流。
如果你全文理解了这篇文章,你会发现我是:
充分理解工具的价值和局限性,比如谷歌能做什么和不能做什么;
熟悉目标信息对象的特征,比如HTML代码里有什么,会有哪些意义;
然后尽可能去寻找曲线救国的方式,就能最大化的带来信息差距,看到别人看不到的价值,
这是我一贯的挖掘理念,我的很多挖掘方式都基于这样的理念。
希望这些思路会对你有帮助!
如果你对这样的挖掘思路感兴趣,可以找我了解会员的内容,点击下方卡片:
私信发送:vip

