这个网站把 AI 知识变成了可以提交的代码题
- 2026-09-25 02:21:01
这个网站把 AI 知识变成了可以提交的代码题
我们在学习机器学习和深度学习时,经常会遇到一种尴尬:公式看懂了,课程也听完了,但真正打开编辑器,仍然不知道怎样把算法写成代码。
比如,我们可能知道 Self-Attention 需要计算 Query、Key 和 Value,也知道注意力分数需要经过缩放和 Softmax;可一旦需要自己处理张量形状、广播、Mask 和多头拆分,就很容易卡住。
最近我发现了一个比较有意思的中文在线学习网站——CodeKy。它尝试把传统算法题库、AI 算法手撕题、模型架构可视化、论文推荐和 AI 助教结合起来,让学习者不仅能“看懂”一个概念,还能把它真正写成可以运行和提交的代码。[1]
CodeKy 是什么?
CodeKy 可以被理解为一个面向算法和人工智能学习者的在线编程训练平台。
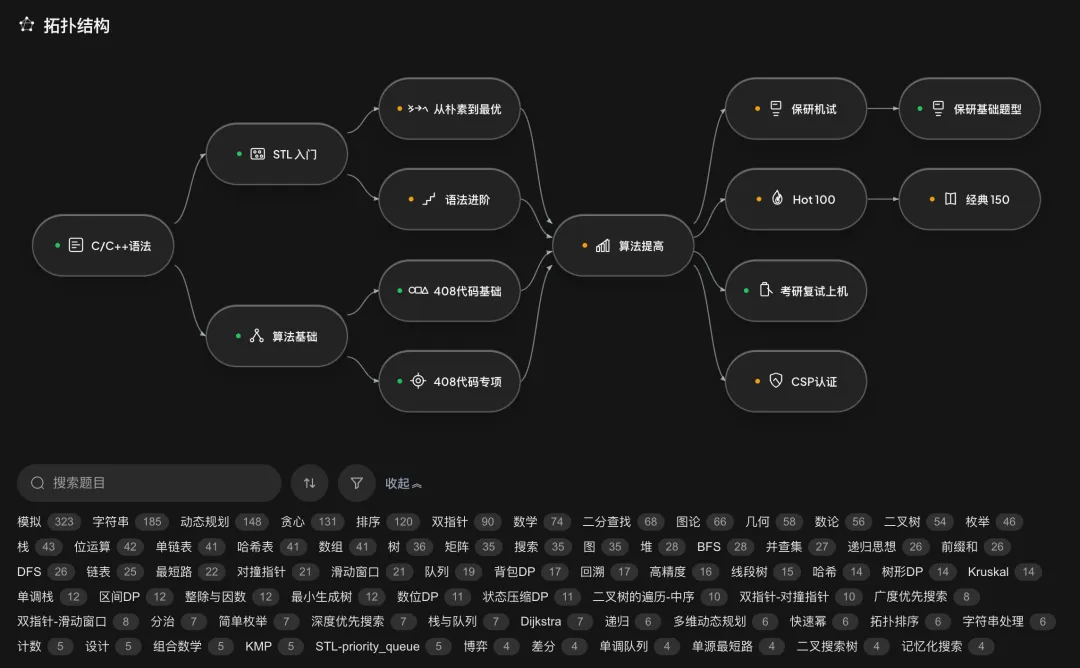
传统题库通常更加关注数组、链表、动态规划、图论和搜索等经典算法;CodeKy 在这些内容之外,又加入了机器学习、深度学习、自然语言处理、强化学习和大语言模型相关题目。
它比较有特色的地方,是把 AI 知识按照依赖关系组织起来,并提供在线编辑、运行、提交和测试功能。学习者可以从 Python 和 NumPy 开始,逐步进入 PyTorch、神经网络、Attention、Transformer、MoE 和大模型对齐等内容。[2]
简单来说,这个平台想解决的是:
学完一个算法之后,怎样确认自己不仅听懂了,而且真的能够把它实现出来?
按知识依赖关系学习 AI
CodeKy 提供了一个 AI 拓扑题库,将知识点按照学习顺序和依赖关系进行组织。
目前能够看到的方向包括:
• Python、NumPy、Pandas 和 PyTorch • 线性代数、概率论和微积分 • 机器学习与深度学习 • NLP、计算机视觉和强化学习 • Attention、Transformer 和位置编码 • MHA、GQA、MLA 和 FlashAttention • LoRA、MoE、RLHF、DPO、PPO 和 GRPO • 损失函数、优化器、激活函数和归一化
这种组织方式与随机刷题不同。它更强调“先掌握什么,再学习什么”。
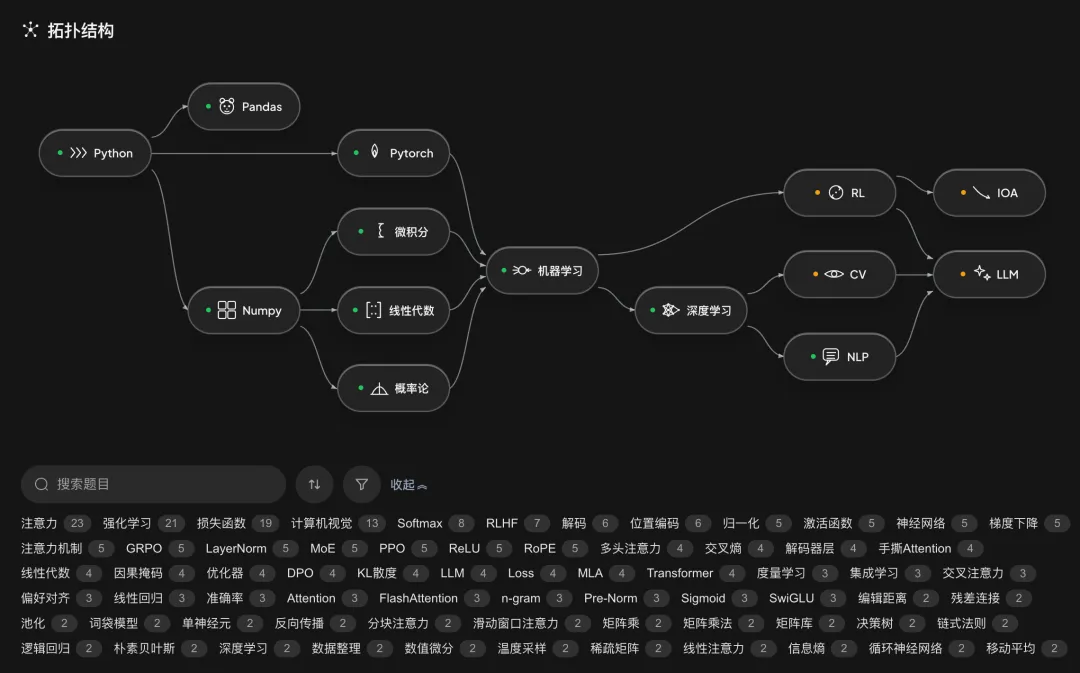
例如,在实现 Transformer 之前,可以先练习矩阵乘法、Softmax、Embedding、LayerNorm 和 Self-Attention;等这些模块比较熟悉以后,再把它们组合成完整的 Transformer Block。
这对初学者很友好,因为你不需要一开始就面对一个庞大的模型仓库,而是可以逐个解决其中的小模块。
把公式真正写成代码
CodeKy 中有不少题目采用函数式判题。
例如,题目可能要求实现一个线性层的前向传播:
def linear_forward(x, w, b):
    """
    实现:x @ w.T + b
    """
    pass
学习者只需要按照题目给出的函数签名完成代码,平台会使用测试样例调用这个函数,并判断结果是否正确。与传统 ACM 题目相比,这种方式通常不需要自己处理复杂的输入和输出格式,因此能够更集中地练习算法本身。
题目涉及的内容包括:
• PCA、KNN、SVM 和线性回归 • 梯度下降与常见优化器 • Softmax、交叉熵和其他损失函数 • Linear、LayerNorm、Dropout 和激活函数 • Self-Attention 与 Multi-Head Attention • RoPE、GQA、MLA 和 KV Cache • Transformer 编码器与解码器 • 强化学习和大模型对齐算法
这类练习特别适合解决“公式会推,但代码不会写”的问题。
在线运行与多框架支持
CodeKy 提供在线代码编辑和判题功能。网站首页显示,平台题目可以涉及 NumPy、PyTorch、TensorFlow、JAX、TinyGrad、Triton 和 CUDA 等不同框架或技术栈。部分算子题还支持 GPU 判题。[1]
提交代码后,平台会运行测试样例并返回结果。对于涉及浮点数的题目,平台会按照一定容差比较输出,而不是简单地进行字符串匹配。
对于学习深度学习的人来说,这意味着不需要每次都在本地重新配置环境。尤其是在练习单个 PyTorch 模块、张量运算或 CUDA 算子时,可以更快地把注意力放在实现逻辑上。
代码卡住时可以询问 AI
CodeKy 的做题页面还提供了 AI 助教功能,主要包括三种使用模式:
• Ask:解释题目、概念和解题思路• Debug:结合题目、样例和当前代码定位问题• Agent:给出更加具体的代码修改建议
例如,在实现二维 Softmax 时,如果误用了全局最大值:
z = x - np.max(x)代码可能在一维输入上通过,却在二维输入上失败。AI Debug 可以结合失败样例,提醒学习者按最后一个维度计算最大值,并保留维度:
z = x - np.max(x, axis=-1, keepdims=True)这种方式的优势是,AI 不仅能看到一条孤立的报错信息,还能结合题目要求、测试样例和当前代码进行分析。
网站目前展示了 DeepSeek、豆包、通义千问、GLM、MiniMax 和 Kimi 等可选模型。不同模型和高级功能可能涉及登录、积分或 AI Credits。
用一组小任务完成完整项目
除了单独的算法题,CodeKy 还提供了项目式学习内容。
目前网站中可以看到的项目包括:
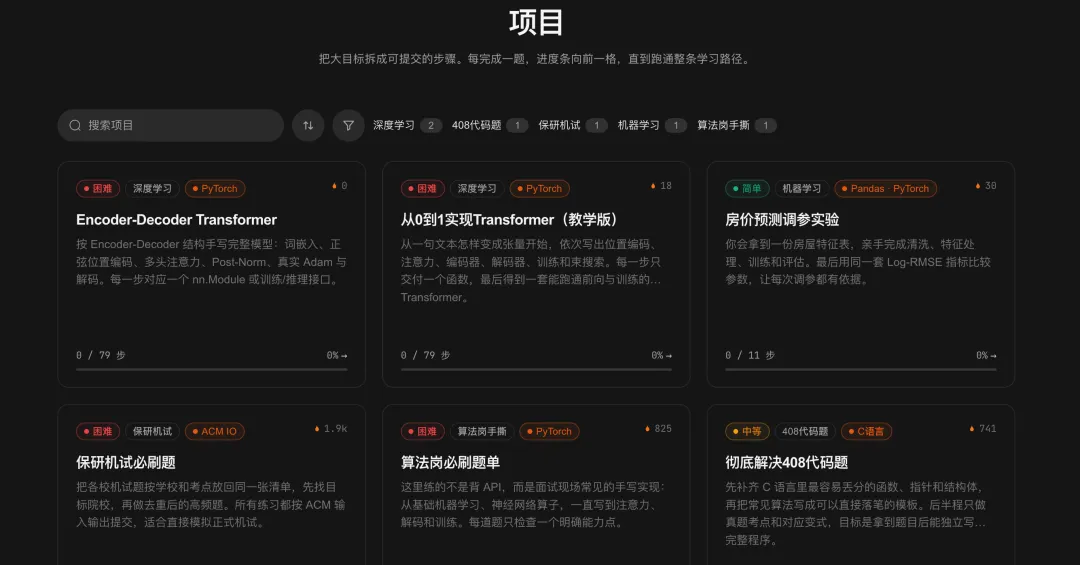
• 从 0 到 1 实现 Transformer • 实现 Encoder–Decoder Transformer • 房价预测与调参实验 • 算法岗必刷题单 • 保研机试必刷题 • 408 代码题训练
其中,Transformer 项目会把完整模型拆成多个可独立提交的步骤。学习者可以从文本转张量开始,依次实现词嵌入、位置编码、多头注意力、编码器、解码器、训练接口和推理解码。
项目式学习的价值在于:每一步只解决一个明确问题,但所有步骤最终又能组合成完整系统。
对于第一次阅读深度学习模型源码的人来说,这比直接面对一个几千行代码的仓库更容易建立整体认识。
可视化理解大模型架构
CodeKy 还提供了一个 LLM 可视化工具,可以观察大语言模型内部的模块组织。[3]
页面中可以选择或查看 DeepSeek、LLaMA、Qwen、Gemma、Mistral 和 Mixtral 等模型,并展示:
• Embedding 和输出层 • Decoder Layer 的重复结构 • Attention、MLP 或 MoE 模块 • LayerNorm 与残差连接 • 模块参数量 • 张量输入输出形状 • KV Cache 占用 • 部分对应的 PyTorch 代码
例如,在 DeepSeek-V2 的教学页面中,可以看到 MLA 和 MoE 在 Decoder Layer 中所处的位置,也可以进一步关联到 Self-Attention、MHA、GQA、RoPE 和 MLA 等手撕题。
这使得模型学习不再只是看一张静态架构图,而是可以在“模型结构—代码实现—相关练习”之间来回切换。
从论文阅读继续走向代码实现
网站的 每日论文 栏目收录了一些经典或热门的人工智能论文和技术报告。[4]
目前页面中可以看到:
• Attention Is All You Need • FlashAttention • LoRA • Direct Preference Optimization • DeepSeek-V2/V3 Technical Report • GQA • LLaMA 2 • RoFormer • Mixtral of Experts
每篇论文会提供简要介绍、关键词和相关方向,部分内容还会连接到站内对应的手撕题。
因此,可以形成一条比较完整的学习路径:
阅读论文
→ 理解核心思想
→ 查看架构可视化
→ 完成相关代码题
→ 自己实现模型模块
→ 在真实项目中应用
对于论文阅读者来说,这一步很重要。因为真正理解一个模型,往往不仅需要知道作者“提出了什么”,还需要弄清楚输入张量是什么、维度怎样变化、模块如何连接,以及训练时损失函数如何计算。
传统算法、求职与竞赛内容
CodeKy 并不只有 AI 题目,还包含较为传统的编程和求职内容,例如:
• C/C++ 语法与 STL • 数组、链表、字符串和二叉树 • 动态规划、图论、搜索和并查集 • Hot 100 与经典题单 • 408 代码专项 • CSP 认证 • 保研机试与考研复试上机 • 算法竞赛和每日一题
求职栏目按照公司和场景整理机考或面试高频题,可以看到华为、字节跳动、小红书、蚂蚁集团、大疆、MiniMax、美团等相关题单。
部分题单已经可以练习,另一些仍显示为“即将上线”。这也说明网站目前仍处于持续建设和扩充内容的阶段。
哪些人适合使用?
CodeKy 比较适合以下学习者:
• 正在学习机器学习和深度学习的初学者 • 想提高 NumPy、Pandas 和 PyTorch 能力的同学 • 能够看懂模型原理,但缺少代码实现经验的人 • 准备算法岗、AI 岗或大模型岗位面试的人 • 想独立实现 Attention 或 Transformer 的学习者 • 需要准备 408、保研机试或算法竞赛的同学
如果你主要从事生物信息学或计算生物学,它也可以作为补充性的 AI 编程训练平台。
例如,在阅读 Geneformer、scGPT 或其他单细胞基础模型时,可以先在 CodeKy 中练习 Embedding、Attention、Pooling、分类头、Softmax 和 Transformer,再回到论文代码中理解完整的模型数据流。
一个推荐的使用顺序
如果你第一次使用 CodeKy,可以按照下面的顺序开始:
1. 完成几道 NumPy 和矩阵运算题 2. 练习 PCA、KNN、线性回归和梯度下降 3. 学习 PyTorch 张量操作和基础神经网络模块 4. 实现 Softmax、LayerNorm 和损失函数 5. 完成 Self-Attention 与 Multi-Head Attention 6. 查看 LLM 架构可视化页面 7. 挑战“从 0 到 1 实现 Transformer”项目 8. 将学到的模块应用到自己的论文复现任务中
不需要一开始追求刷很多题。更有效的方式是:完成一道题后,确认自己能解释输入输出、张量形状、数学公式和代码实现之间的对应关系。
总结
CodeKy 最有价值的地方,是尝试把抽象的 AI 知识拆解为可以运行、提交和验证的代码任务。
它关注的不只是“你知不知道这个概念”,还进一步追问:
你能不能亲手把这个算法写出来,并让它通过测试?
对于正在学习 NumPy、PyTorch、Attention 和 Transformer,或者准备 AI 算法岗位面试的人来说,CodeKy 可以作为课程、论文和真实项目之外的代码训练补充。
如果你也经历过“原理好像听懂了,但代码还是不会写”的阶段,可以从一道简单的矩阵运算题开始,逐步走向完整的模型实现。
网站地址:https://codeky.online/
参考链接
1. CodeKy. “CodeKy 首页.” https://codeky.online/↩︎2. CodeKy. “AI 算法题库.” https://codeky.online/problems?topology=ai↩︎3. CodeKy. “LLM 可视化工具.” https://codeky.online/learn/llm-viz↩︎4. CodeKy. “每日论文.” https://codeky.online/learn/daily-papers↩︎

