一行代码都没写!这篇3分+文献全靠网页工具,把肺癌/乳腺癌代谢讲透了
- 2026-11-22 15:14:12
现在做生信,大家是不是一上来就卷单细胞、卷101种机器学习组合?算法越来越复杂,门槛越来越高。但今天带大家看一篇2026年6月刚发在 PLOS One 上的清流文章。
这篇文献连一行代码都没写,没有任何高深的模型,全靠几个免费网页工具(Ualcan、DGIdb、STRING等)‘搭积木’,就把肺癌和乳腺癌的代谢差异讲得明明白白。
为什么它能发?因为它抓住了临床痛点:同样是代谢重编程,肺腺癌、肺鳞癌、乳腺癌,甚至转移性乳腺癌,底层逻辑根本不一样! 作者用公共数据算出差异,然后去药物数据库里找现成的FDA批准药物,最后甚至去临床试验注册中心(ClinicalTrials.gov)查了这些药有没有在对应癌症里做试验。这种‘零代码+纯公共数据库+极强临床转化感’的套路,绝对是发中低分优质文章的利器,今天必须把它扒干净。

文献概况
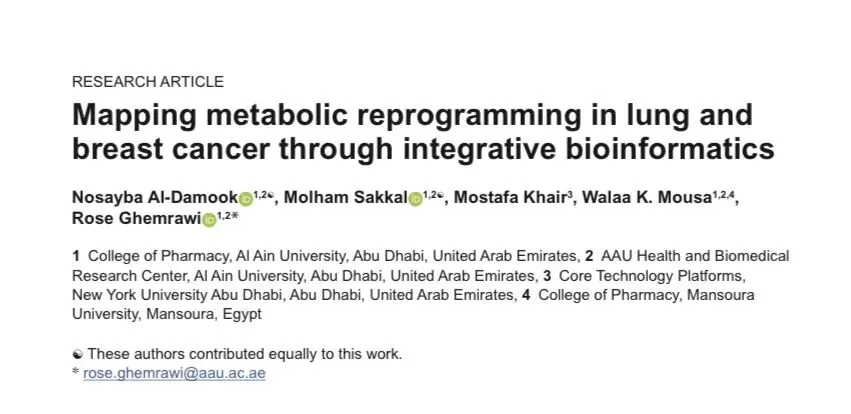
文献名称:Mapping metabolic reprogramming in lung and breast cancer through integrative bioinformatics
中文标题:通过整合生物信息学映射肺癌和乳腺癌的代谢重编程
发表时间:2026.6
发表期刊:PLOS One
研究重点:对比了四种癌症状态(肺腺癌LUAD、肺鳞癌LSC、原发性乳腺癌BRCA、转移性乳腺癌MET500)的代谢重编程异质性,并利用公共数据库打通了“靶点发现-老药新用-临床试验匹配”的闭环。


文章解读


核心方法
🔹 差异表达分析(Ualcan):调取TCGA和MET500数据,算代谢相关基因在四种癌症里的表达差异。 🔹药物-基因互作(DGIdb):把差异基因扔进去,找有没有FDA已批准的靶向药。 🔹 疾病关联分析(Open Targets):看这些基因在遗传学上和这些癌症的关联强不强。 🔹功能与通路富集(Enrichr):跑KEGG和GO,看这些基因到底在哪些代谢通路上富集。 🔹蛋白互作网络(STRING/Cytoscape):看关键蛋白之间怎么互相作用,找Hub节点(核心枢纽)。 🔹 临床与生存验证(Ualcan & 临床试验中心):验证核心基因的预后价值,并检索对应药物的临床试验进展。这些基因到底在哪些代谢通路上富集。 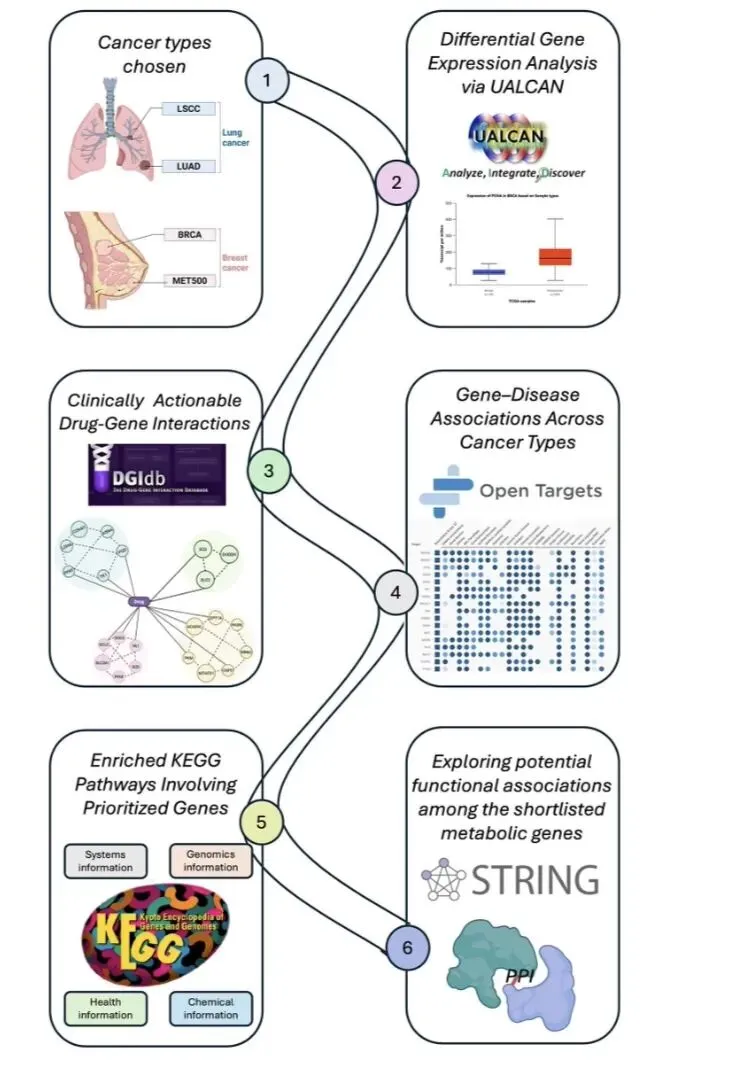


研究结果


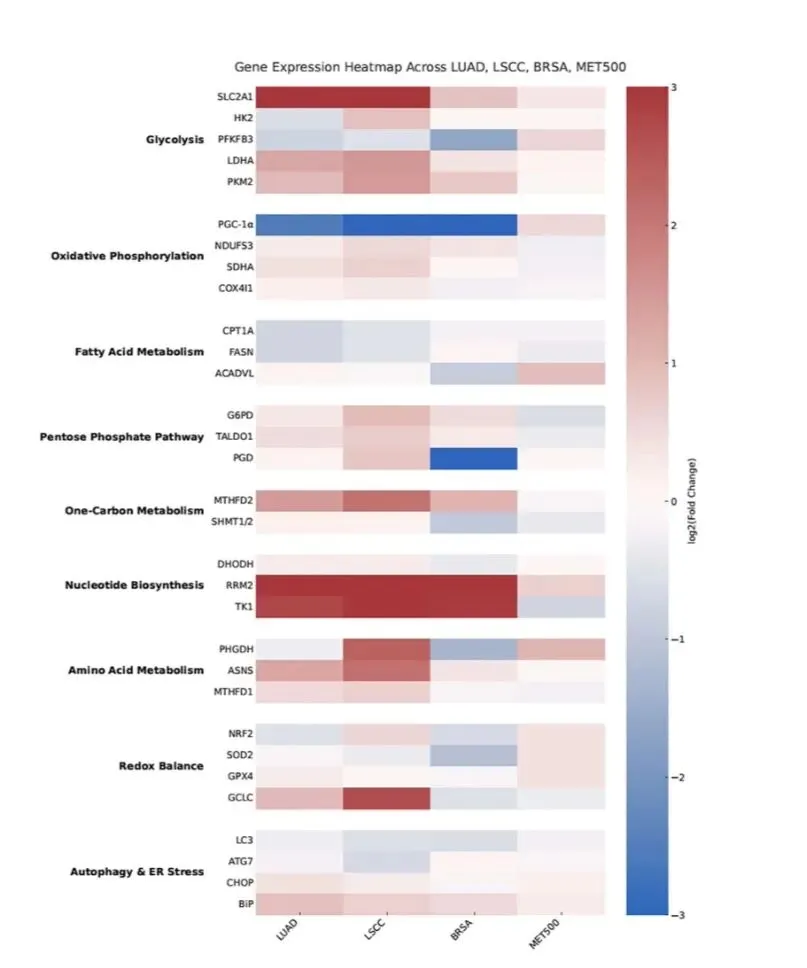
💡四种癌症,四套代谢策略:
• 肺腺癌(LUAD):纯粹的“糖酵解”狂魔。
• 肺鳞癌(LSC):糖酵解+氧化磷酸化,双管齐下。
• 乳腺癌(BRCA):疯狂进行合成代谢和脂肪生成。
• 转移性乳腺癌(MET500):主打应激适应(抗氧化、自噬),为了在转移过程中活下来。
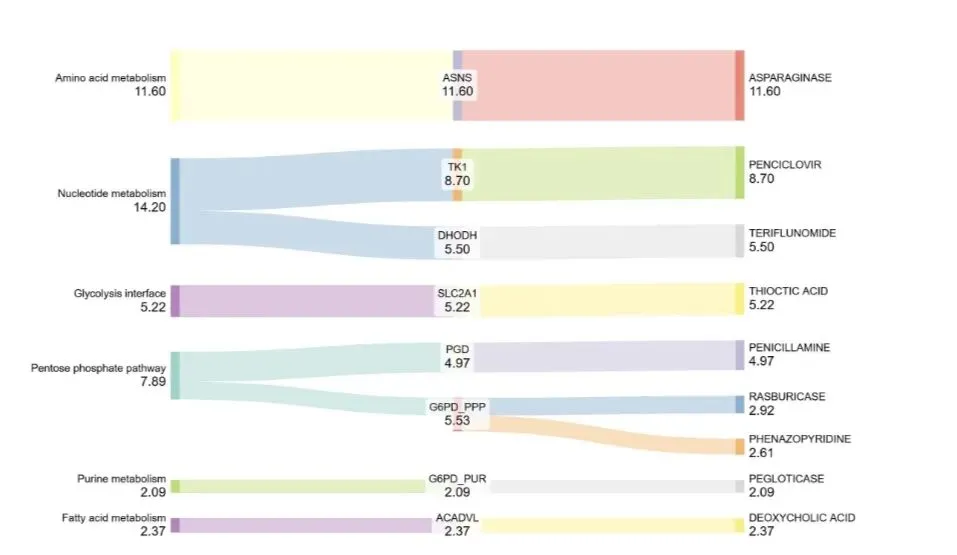
💡挖出核心靶点网络:锁定了几个关键代谢枢纽,比如 G6PD(磷酸戊糖途径的核心,负责抗氧化和核苷酸合成),以及 SLC2A1(糖转运蛋白)、TK1 等。
💡老药新用(Drug Repurposing):发现 ASNS 基因对应天冬酰胺酶(Asparaginase),G6PD 对应拉布立酶(Rasburicase),SLC2A1 对应硫辛酸(Thioctic acid)。并发现部分药物已经在转移性乳腺癌的临床试验中。
.💡预后价值:比如在肺腺癌中,SLC2A1 高表达和极差的总生存期显著相关;TK1 在乳腺癌中也有类似作用。

研究结论
🔥高分密码
✅ 降维打击的“零代码”思路:不拼算力、不拼算法,拼的是“把多个数据库的结论互相印证”。一套连招下来,逻辑非常严密。
✅ 多癌种对比的降维视角:没有死磕单癌种,而是把肺癌的两种亚型、乳腺癌的原发和转移放在一起比。这种“寻找异质性”的框架,比单纯描述单一疾病更有新意。
✅ 把“干生信”做出了“临床感”:最绝的一步是去检索了临床试验。这让文章从“一堆冷冰冰的图表”直接落地到了“未来的用药指导”,极大地提升了文章的价值感。
这篇文献没有产生任何一个新数据,全靠“借力打力”,把公开数据库里的信息像侦探拼图一样拼在一起。它用最基础的在线工具,讲出了最贴近临床的代谢重编程故事。 这也印证了我们开头说的:别盲目卷高深算法,逻辑闭环才是王道。
如果你手里有现成的公共数据,但不知道怎么做差异分析、不知道怎么找靶点;或者你代码基础薄弱,想学这种“纯网页工具+多数据库串联”的套路来发文章;又或者你想把现有的数据加上临床注册信息和药物靶点的Buff——随时来找我们。我们帮你梳理分析逻辑、匹配最合适的公共数据库,把你觉得平平无奇的数据,包装成逻辑极其严密、能让审稿人挑不出毛病的高分Paper。
📖往期特辑: 不卷组蛋白,卷非组蛋白乙酰化:这篇9.9分纯生信用101种算法+单细胞+病理组学讲透了 化疗打完了,哪类细胞还在“帮”肿瘤?这篇4.9分文章用hdWGCNA+多算法揪出了元凶 别再用大模型“背答案”了!强生团队这篇新作,用“虚拟细胞世界模型”把扰动预测卷到了新高度 肿瘤细胞如何“忽悠”内皮细胞?这篇3分+文献用空间转录组抓了个现行
文献概况
文献名称:Mapping metabolic reprogramming in lung and breast cancer through integrative bioinformatics
中文标题:通过整合生物信息学映射肺癌和乳腺癌的代谢重编程
发表时间:2026.6
发表期刊:PLOS One
研究重点:对比了四种癌症状态(肺腺癌LUAD、肺鳞癌LSC、原发性乳腺癌BRCA、转移性乳腺癌MET500)的代谢重编程异质性,并利用公共数据库打通了“靶点发现-老药新用-临床试验匹配”的闭环。
文章解读
核心方法
研究结果
💡四种癌症,四套代谢策略:
• 肺腺癌(LUAD):纯粹的“糖酵解”狂魔。
• 肺鳞癌(LSC):糖酵解+氧化磷酸化,双管齐下。
• 乳腺癌(BRCA):疯狂进行合成代谢和脂肪生成。
• 转移性乳腺癌(MET500):主打应激适应(抗氧化、自噬),为了在转移过程中活下来。
💡挖出核心靶点网络:锁定了几个关键代谢枢纽,比如 G6PD(磷酸戊糖途径的核心,负责抗氧化和核苷酸合成),以及 SLC2A1(糖转运蛋白)、TK1 等。
💡老药新用(Drug Repurposing):发现 ASNS 基因对应天冬酰胺酶(Asparaginase),G6PD 对应拉布立酶(Rasburicase),SLC2A1 对应硫辛酸(Thioctic acid)。并发现部分药物已经在转移性乳腺癌的临床试验中。
.💡预后价值:比如在肺腺癌中,SLC2A1 高表达和极差的总生存期显著相关;TK1 在乳腺癌中也有类似作用。
研究结论
研究结论
🔥高分密码
✅ 降维打击的“零代码”思路:不拼算力、不拼算法,拼的是“把多个数据库的结论互相印证”。一套连招下来,逻辑非常严密。
✅ 多癌种对比的降维视角:没有死磕单癌种,而是把肺癌的两种亚型、乳腺癌的原发和转移放在一起比。这种“寻找异质性”的框架,比单纯描述单一疾病更有新意。
✅ 把“干生信”做出了“临床感”:最绝的一步是去检索了临床试验。这让文章从“一堆冷冰冰的图表”直接落地到了“未来的用药指导”,极大地提升了文章的价值感。
这篇文献没有产生任何一个新数据,全靠“借力打力”,把公开数据库里的信息像侦探拼图一样拼在一起。它用最基础的在线工具,讲出了最贴近临床的代谢重编程故事。 这也印证了我们开头说的:别盲目卷高深算法,逻辑闭环才是王道。
如果你手里有现成的公共数据,但不知道怎么做差异分析、不知道怎么找靶点;或者你代码基础薄弱,想学这种“纯网页工具+多数据库串联”的套路来发文章;又或者你想把现有的数据加上临床注册信息和药物靶点的Buff——随时来找我们。我们帮你梳理分析逻辑、匹配最合适的公共数据库,把你觉得平平无奇的数据,包装成逻辑极其严密、能让审稿人挑不出毛病的高分Paper。

