【网站统计源码】自己搭站的人注意,独立访客数可能是假的
- 2026-10-20 21:58:10
SOURCE REVIEW · 源码拆解
“
自己搭站的人注意,独立访客数可能是假的
本文看点
Q1
UV 到底怎么算的
Q2
三个面板各管什么
Q3
SPA 与爬虫两个坑
WHY UV LIES
独立访客是怎么被算出来的
打开统计后台的那一下最让人上头——曲线往上走,数字在涨,你会觉得今天这波更新没白熬。
然后你顺手点开「实时访客」,看见一个 IP 在那儿反复刷新。
那一刻的数字就开始骗你了。
UV 这个词本身就是个约定,不是一个客观存在的事实。它叫「独立访客」,业内常见做法是浏览器第一次访问时种一个匿名标识,之后带着这个标识回来,统计侧按标识去重,一天算一个。
听着很干净。问题在于这套机制从根上就带三个洞。
Cookie 能被清。用户清了浏览器数据,昨天算一个的人今天又算一个,UV 只涨不跌。
设备会分裂。一个人用手机看文章、用电脑看文章、用平板回看消息,跨设备无法关联,三次就是三个访客。
IP 会骗人。同一间办公室共用一个出口 IP,按 IP 去重,一整层楼的人算成一个;反过来动态拨号用户换 IP,同一个人被反复计数。
所以稍微讲究一点的实现会做组合去重——已登录的直接拿用户标识,没登录的拿 IP 加浏览器标识做哈希,再挂一个 24 小时的有效窗口。仍然不精确,但比纯 Cookie 或纯 IP 都稳一截。
取舍很明确:想要连续性就得接受不准确,想要准确就得接受断代。两头都要不了。
THREE PANELS
后台那三个面板各管什么
这套系统的功能排布是典型的三段式。
数据概况
给的是 PV、UV、IP 三个总数。PV 最容易理解:页面被加载一次就加一,重复刷新照算。它衡量流量大小,不衡量人。
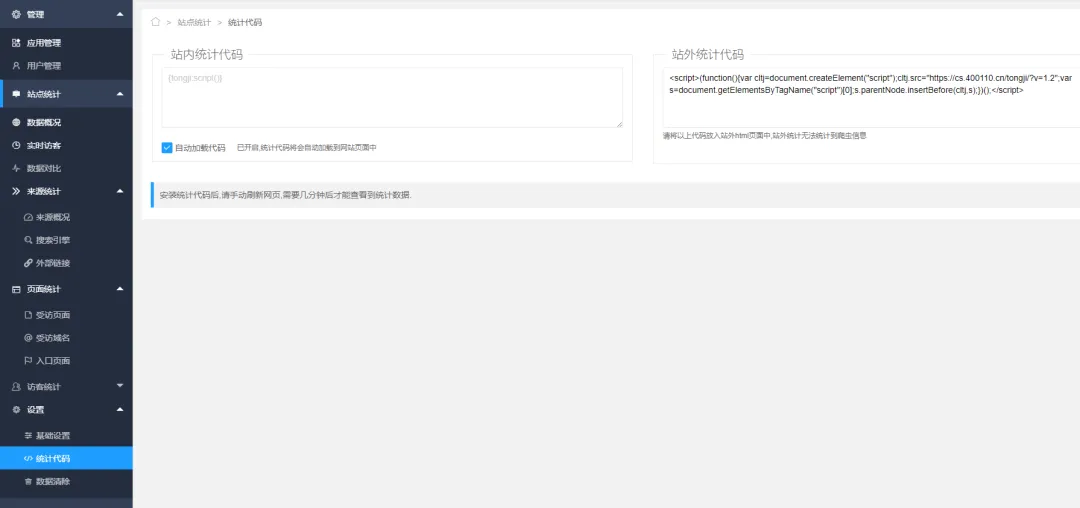
实时访客
给的是会话列表,谁在什么时候进了哪个页面、看了多久。这里能看出访问路径,也能一眼认出那些停留时间不到两秒就跳走的——多半是误点,不是真读者。
数据对比
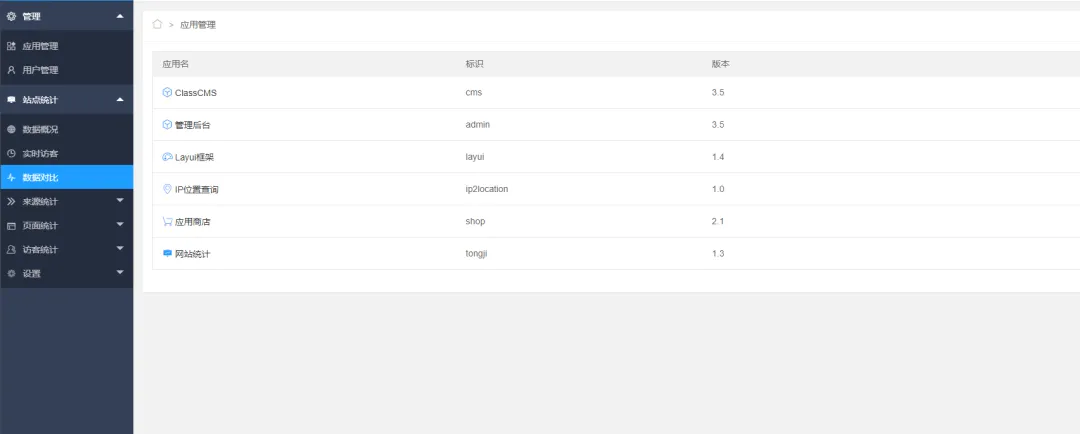
两个时间段放一起看,PV、UV、IP、平均访问时长、页数、蜘蛛和爬虫都在里面。这一栏最实用:单看今天涨了没用,两段一对,才知道是流量真的来了,还是某个链接被人在群里刷了一轮。
顺带一个衍生指标值得单独记住:人均 PV 也就是 PV 除以 UV。这个值低,说明人来了翻两下就走;这个值高,说明内容粘得住。
SPA TRAP
最容易踩的一个坑
现在大量站点用 Vue、React 这类框架,页面切换走的是路由,不刷新浏览器。这时候如果统计代码没监听路由变化,所有页面的 PV 会永远停在第一次加载的那个数上。
后台一片祥和,实际上只有 1。
这个坑很隐蔽,因为数字看着有、只是不动。你不主动去核对每篇文章的 PV 分布,根本发现不了。
还有一层更省事的思路:干脆不埋代码,直接读服务器日志。访问日志里天然记着时间、路径、IP、状态码,解析一遍就出数据,还顺手绕开了广告拦截插件的干扰。代价是丢掉屏幕分辨率这类只有浏览器才有的信息,收益是数据完整度反而更高。
BOT FILTER
爬虫为什么要单独拎出来
系统里把蜘蛛、爬虫单独列一栏,不是为了好看。
爬虫的访问密度远高于真人,一个收录良好的站点每天被爬几千次很常见。全量统计的话,PV 里可能一大半根本不是人。
过滤的办法不算复杂:按浏览器标识做正则匹配,把常见爬虫特征剔掉,再看剩下的请求路径——静态资源、接口路径、健康检查这类通通不算页面浏览。有效请求只留 GET 方法和 200 响应,跳转页和错误页都排掉。
WORTH IT
值不值得上这套
如果你的站每天几十个访客,第三方统计的免费额度够用,装一段脚本就能用,那自建确实没什么必要——多一台机器、多一份运维、多一个数据表要维护。
真要上,先想清楚三件事。
口径先写下来
用什么标识认人、什么算一次访问、多久没动算会话结束,先落成文字再动手。口径不统一,后面所有数字都没法互相比较。
去重维度选一个
Cookie、IP 加标识、还是登录标识,选定就别中途换。换了,历史数据就断了。
数据留多久
只增不减的数据库迟早是麻烦,定个保留窗口,定时清掉超出部分,顺便把备份也压小。
更倾向的做法是:日志分析打底,登录用户的真实行为单独补上。前者保证「有多少人」,后者回答「他们做了什么」,两套数据各管一段,别指望一个数字全包。
源码标注的是上传到服务器后直接访问域名就进入安装流程,装完就能看数据。搭建门槛确实不高,但把上面那几个口径问题想清楚,比装完更重要。
资源来源:源码库 bbbb.bid/37171.html关注星标公众号不定期分享各种源码「回复消息」查看原始资源

