84K Star!一行代码把网页变成AI口粮!太香了!
- 2026-10-24 03:55:14
推荐阅读:
大家好!我是老码!
最近在给一个小项目攒 RAG 知识库,最烦的就是爬网页:BeautifulSoup 写一堆清洗逻辑,抓回来的还是导航栏、页脚、版权声明混成一团的 HTML,直接塞给大模型,token 全烧在噪音上。后来在 GitHub 上翻到 Crawl4AI,用下来确实顺手,今天安利一下。
它是个专门给 LLM 打工的开源爬虫,84K Star,GitHub 上星最多的爬虫项目之一,Apache-2.0 协议,pip install -U crawl4ai 装完就能用,不注册账号、不要 API key。核心卖点一句话:把任意网页变成干净的、AI 直接能吃的 Markdown。
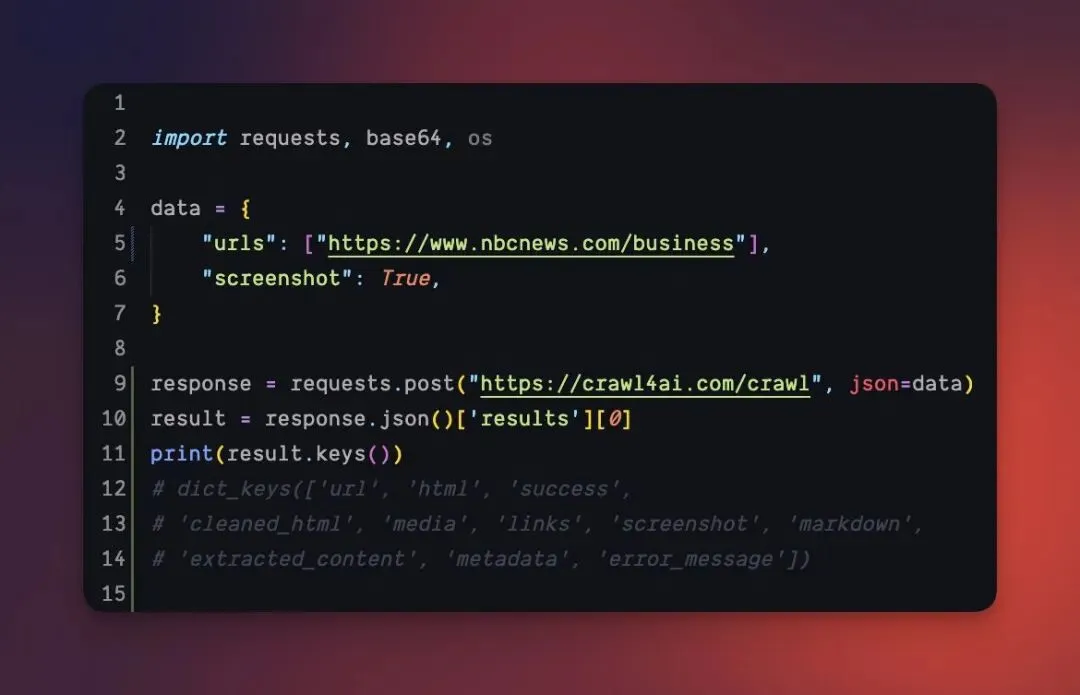
用法是真简单:
import asyncio from crawl4ai import AsyncWebCrawler async def main(): async with AsyncWebCrawler() as crawler: result = await crawler.arun(url="https://news.ycombinator.com") print(result.markdown) asyncio.run(main()) 跑完 result.markdown 就是洗好的正文。它内置两种启发式过滤器:一个按标签结构剪掉导航和页脚,一个用 BM25 按你的查询词留住相关段落。不调 LLM、不花一分钱,噪音就能剔掉大半,批量爬站的时候太省了。
第二层是结构化提取。页面规整就用 CSS 选择器或 XPath 直接抓,快且免费:
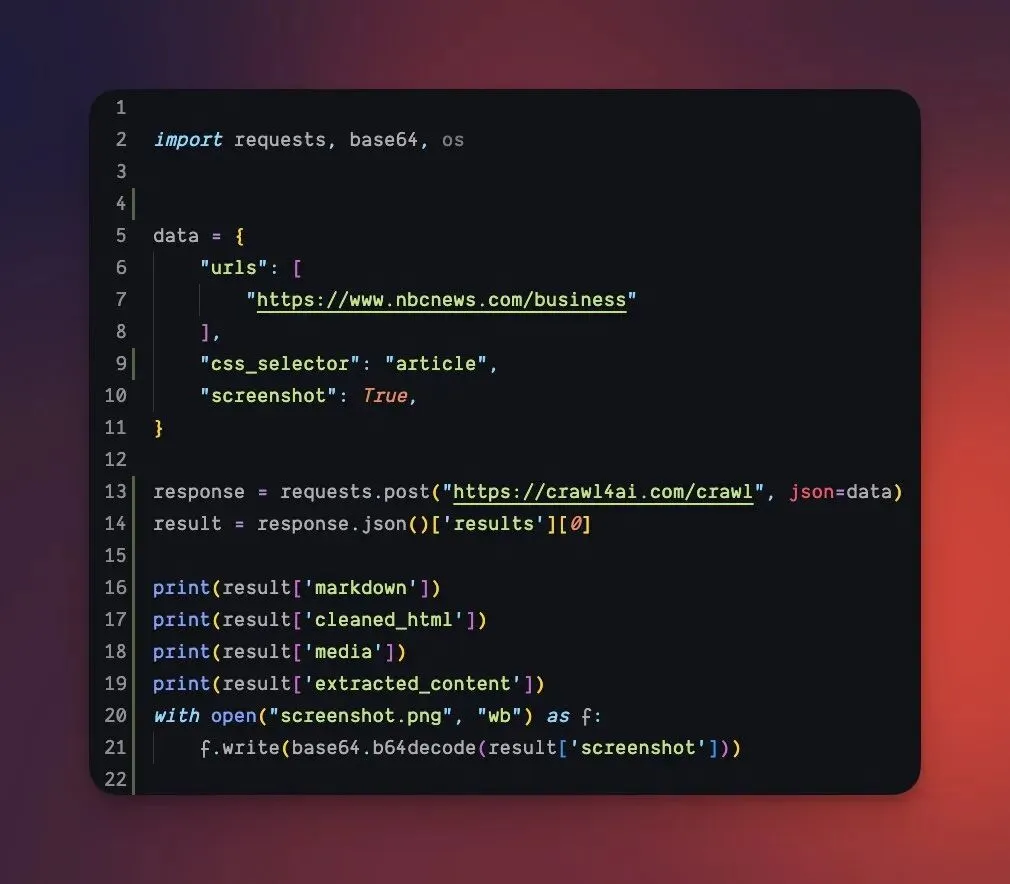
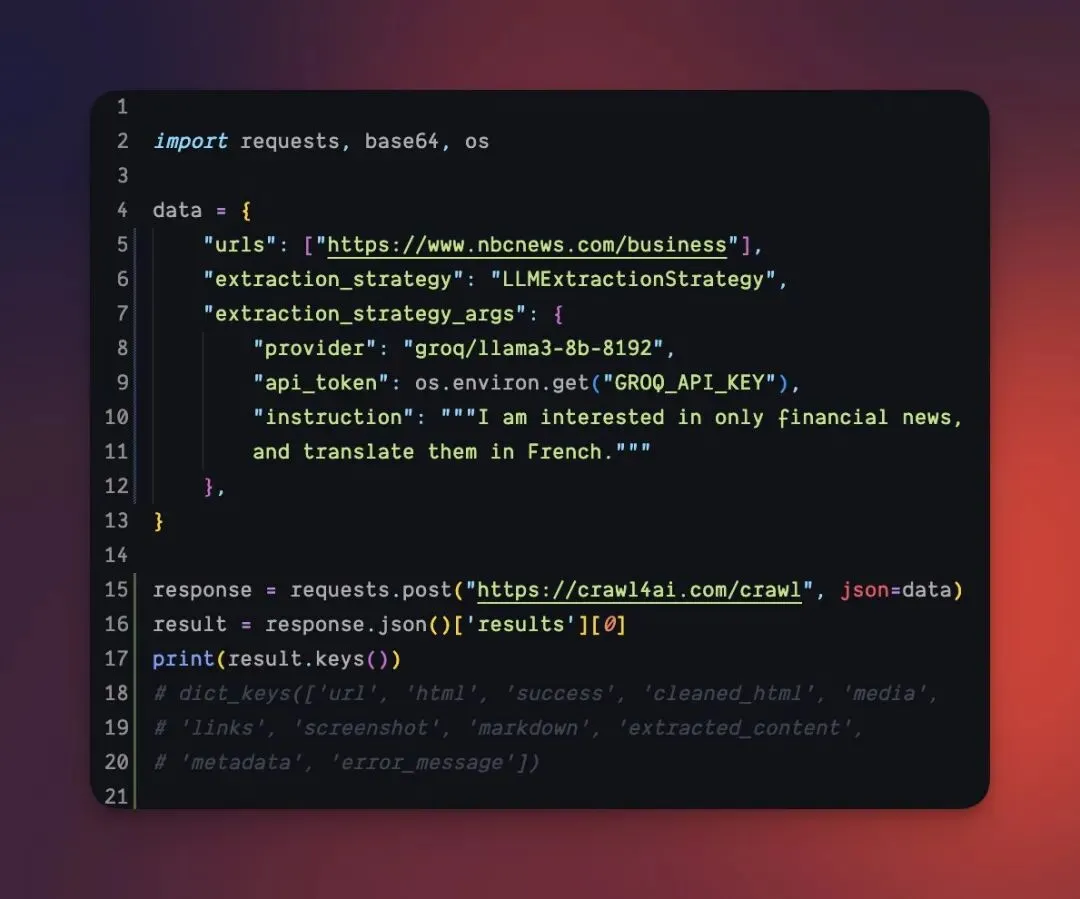
页面乱、或者要语义理解时,换 LLMExtractionStrategy,定义一个 Pydantic 模型描述你要什么字段,它按 schema 吐 JSON,连选择器都不用写。
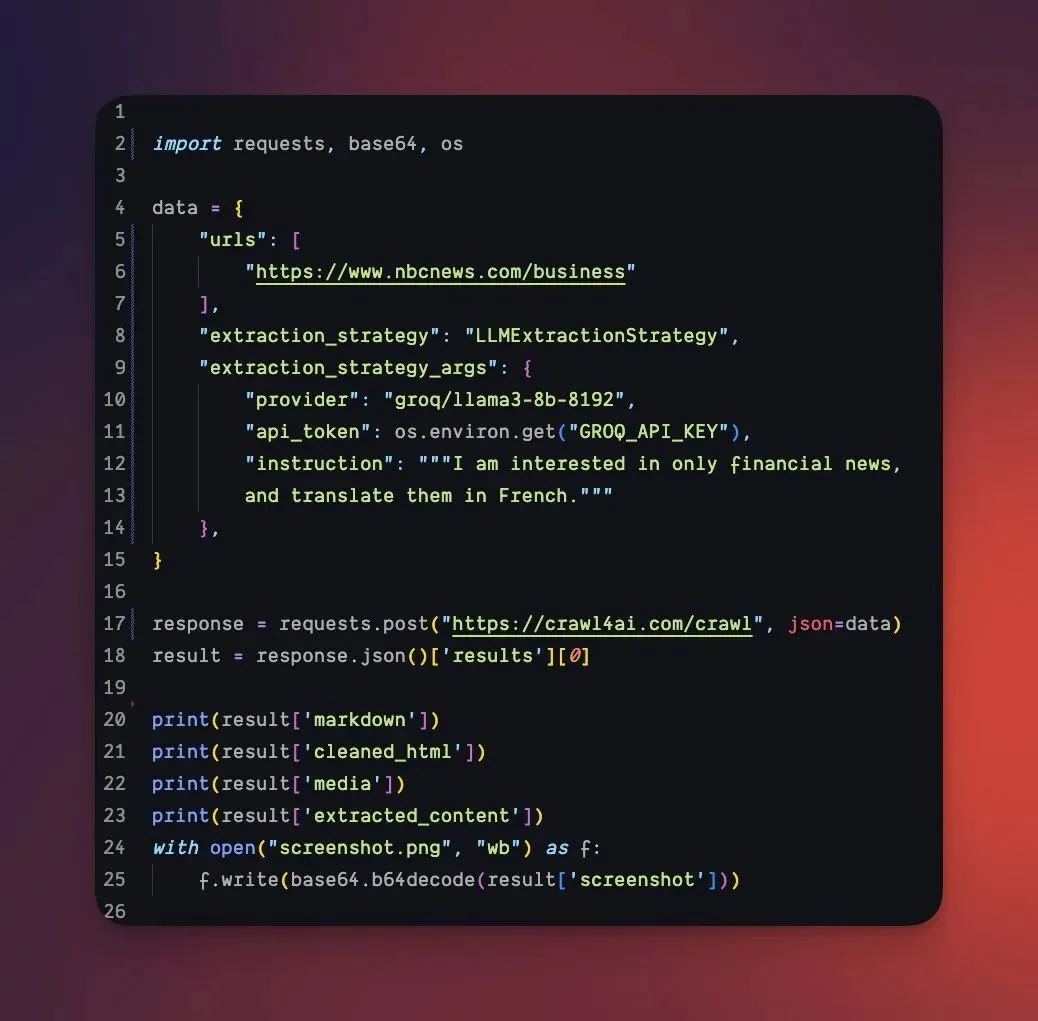
模型随便接,OpenAI、Gemini 都行,本地 Ollama 也能挂,数据不出门。
第三层是浏览器控制,这是它比 requests 类库强的地方。底层是 Playwright,JS 渲染的页面照样爬,还能注入自己的 JS。比如爬资讯列表时自动点一下"加载更多",或者等某个元素出现再动手:
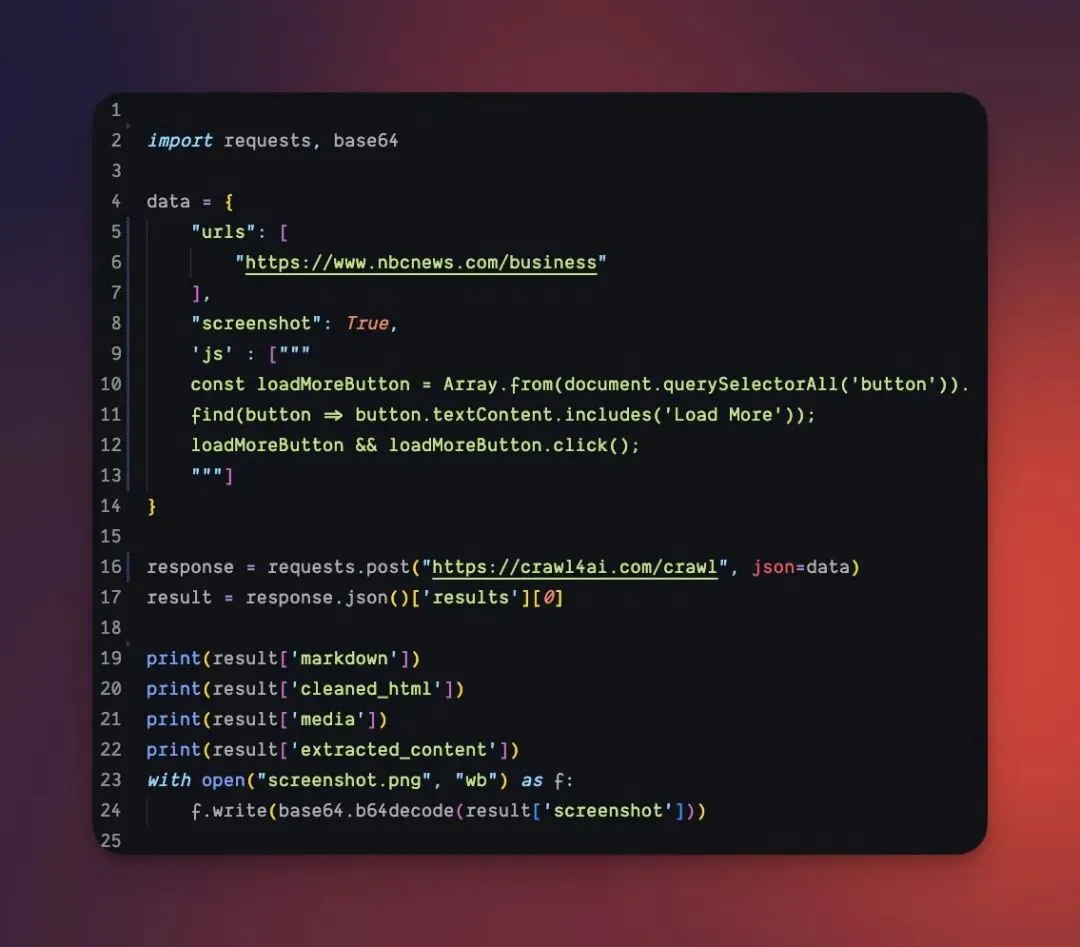
代理、headers、cookie 会话复用、隐身模式都有,爬的时候顺手截图存档也支持。
爬整站不慌。深度爬取有 BFS、DFS、best-first 三种策略,配 FilterChain 过滤 URL;断点续爬也加了,中途挂了从 resume_state 接着跑。还有个挺聪明的 adaptive crawling:不数页数,而是判断信息够不够回答你的问题,够了就停,省时间也省带宽。
部署姿势随意。当 Python 库用可以,起 Docker 也行,官方镜像自带 FastAPI 服务和 Playground 网页,新版默认带鉴权、只绑本机,安全姿势端正了不少。它还有 MCP 接口,一行命令把爬虫挂给 Claude Code、Cursor 这类编程智能体,AI 要查资料自己就会去爬。官方最近也出了云 API,但开源版没有任何阉割,自托管完全够用。
跟 Scrapy 比一句:Scrapy 是通用爬虫框架,啥都能干,但清洗管线得自己搭;Crawl4AI 把"给 AI 喂数据"这一件事做成了开箱即用,像我这种只想快速攒语料的,用着省心。
地址:github.com/unclecode/crawl4ai
反正免费开源,下回要给 AI 喂网页数据,先试试它。
往期推荐:

